सार:
डीपसीक भी पैरामीटर प्रतियोगिता में शामिल हो गया है। सूचना के अनुसार, डीपसीक वर्तमान में लगभग 2 ट्रिलियन मापदंडों के साथ एक नए मॉडल का प्रशिक्षण कर रहा है; लियांग वेनफेंग ने हाल ही में एक निवेशक बैठक में यह भी कहा कि कंपनी का अगला कदम मॉडल को 8 ट्रिलियन मापदंडों तक आगे बढ़ाना जारी रखना है। एक साल पहले, 8 ट्रिलियन अभी भी एक अकल्पनीय संख्या थी।
लेकिन अब, किमी K3 2.8 ट्रिलियन मापदंडों तक पहुंच गया है; बाइट एक नए मॉडल का पूर्व-प्रशिक्षण कर रहा है जो 10 ट्रिलियन मापदंडों तक पहुंच सकता है; अलीबाबा ने सार्वजनिक रूप से यह भी कहा है कि अगली पीढ़ी का मॉडल 5 ट्रिलियन से 10 ट्रिलियन मापदंडों की ओर बढ़ेगा। एंथ्रोपिक मॉडल मापदंडों का खुलासा नहीं करता है, लेकिन एफटी ने पहले उद्योग के अनुमानों को उद्धृत करते हुए कहा है कि इसके नवीनतम फ्लैगशिप मिथोस 5 में लगभग 8 ट्रिलियन पैरामीटर हैं।
बड़ा मॉडल एक घेरे में घूम गया और फिर से यह देखने के लिए प्रतिस्पर्धा करने लगा कि कौन बड़ा है।
केवल इस बार, जो पैरामीटर हर कोई रोल आउट करता है वह स्केलिंग के पिछले दौर के समान पैरामीटर नहीं रह गए हैं।
जब डीपसीक ने इस साल अप्रैल में वी4-प्रो जारी किया, तो आधिकारिक तौर पर घोषित पैमाना 1.6 ट्रिलियन कुल पैरामीटर और 49 बिलियन सक्रियण पैरामीटर था।
अनुवर्ती योजना आरएमबी 8 ट्रिलियन है, जो वी4-प्रो के 5 गुना के बराबर है।
जब डीपसीक की बात आती है तो यह वास्तव में काफी असामान्य है। आख़िरकार, डीपसीक ने पिछले साल मापदंडों के संदर्भ में नहीं, बल्कि पूरे एआई उद्योग पर सबसे गहरी छाप छोड़ी।
इसने एक बार AI उद्योग को फिर से चर्चा करने पर मजबूर कर दिया था कि शायद अत्याधुनिक मॉडलों को GPU को असीमित रूप से जलाने की आवश्यकता नहीं है।
जब 2024 के अंत में वी3 जारी किया जाता है, तो डीपसीक जानबूझकर प्रशिक्षण बिल को मेज पर रखता है: 671 बिलियन कुल पैरामीटर, प्रति टोकन 37 बिलियन पैरामीटर सक्रिय होते हैं, और पूर्ण प्रशिक्षण में 2.788 मिलियन एच800 जीपीयू घंटे की खपत होती है। 2 अमेरिकी डॉलर प्रति जीपीयू घंटे की गणना के अनुसार, आधिकारिक प्रशिक्षण लागत केवल 5.576 मिलियन अमेरिकी डॉलर है।
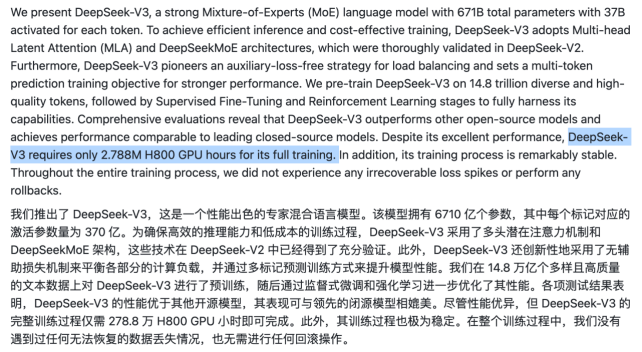
यह संख्या और इसके पीछे की दक्षता, बाद में डीपसीक के लिए सबसे महत्वपूर्ण लेबलों में से एक बन गई।
डीपसीक के पास ओपनएआई और एंथ्रोपिक जैसे उन्नत जीपीयू की प्रचुर आपूर्ति नहीं है; कंपनी लंबे समय से अपने स्व-आधान की मात्रा निर्धारित करने के लिए लियांग वेनफेंग के हुआनफैंग पर निर्भर रही है और बाहरी वित्तपोषण स्वीकार नहीं करती है। इसकी स्थितियाँ इसका मार्ग निर्धारित करती हैं - चूँकि पैसा और कंप्यूटिंग शक्ति सीमित है, इसलिए प्रदर्शन को वास्तुकला, प्रशिक्षण और अनुमान दक्षता से अधिकतम किया जाना चाहिए।
लेकिन अब स्थितियां बदल गई हैं.
डीपसीक ने इस साल जून में अपनी स्थापना के बाद से बाहरी वित्तपोषण का अपना पहला दौर पूरा कर लिया है, जिसमें लगभग 7.4 बिलियन अमेरिकी डॉलर जुटाए गए हैं। वर्तमान में, लगभग RMB 50 बिलियन (लगभग US$7.5 बिलियन) के वित्तपोषण का दूसरा दौर लगभग RMB 500 बिलियन के मूल्यांकन के अनुरूप अंतिम चरण में प्रवेश कर चुका है। यदि यह वित्तपोषण सफलतापूर्वक पूरा हो जाता है, तो कुछ ही महीनों में डीपसीक का संचयी बाह्य वित्तपोषण 15 बिलियन अमेरिकी डॉलर और लगभग 100 बिलियन युआन के करीब होगा।
उसी समय, डीपसीक ने विज्ञान और प्रौद्योगिकी नवाचार बोर्ड के आईपीओ की तैयारी के लिए CITIC सिक्योरिटीज को काम पर रखा है, और नई पूंजी का उपयोग स्पष्ट रूप से कंप्यूटिंग बुनियादी ढांचे, मॉडल विकास और प्रतिभा निवेश के लिए किया जाएगा; 21 सितंबर को, हिलहाउस वेंचर पार्टनर्स के पूर्व पार्टनर यान वेंटाओ आधिकारिक तौर पर डीपसीक में शामिल हो गए और सीएफओ के रूप में कार्य किया, जिससे कंपनी की स्थापना के बाद से तीन वर्षों में सीएफओ की रिक्ति समाप्त हो गई।
अतीत में, डीपसीक ने मॉडल को यथासंभव अच्छा बनाने के लिए सीमित धन और कंप्यूटिंग शक्ति का उपयोग किया था; अब वित्तपोषण और लिस्टिंग को आगे बढ़ाया जा रहा है। हाथ में अधिक पैसा होने से कंप्यूटिंग शक्ति को भी बढ़ाया जा सकता है।
शर्तें पूरी होने के बाद, डीपसीक भी साहसपूर्वक मापदंडों को लागू करना शुरू कर देता है।
यह दक्षता की खोज के साथ टकराव नहीं करता है। जब दक्षता अधिक होती है, तो उसी पैसे से पैमाने का विस्तार किया जा सकता है।
पिछले दो महीनों में, अत्याधुनिक मॉडलों के कुल पैरामीटर पैमाने में उल्लेखनीय वृद्धि हो रही है।
इस प्रतियोगिता को फिर से सुर्खियों में लाना द डार्क साइड ऑफ़ द मून है। इस साल जुलाई में किमी K3 ने 2.8 ट्रिलियन कुल पैरामीटर और 104 बिलियन एक्टिवेशन पैरामीटर हासिल किए। K3 अभी भी सबसे बड़े पैरामीटर स्केल वाला ओपन वेट मॉडल है जिसे आधिकारिक तौर पर जारी किया गया है।
यह सिर्फ बड़ा नहीं है. आधिकारिक मूल्यांकन में, K3 का GPQA डायमंड 93.5 तक पहुंच गया, और टर्मिनल-बेंच 2.1 88.3 तक पहुंच गया, जो इसी अवधि में GPT-5.6 Sol और क्लाउड फैबल 5 के बहुत करीब है। पैमाना खरबों तक पहुंच गया है, और प्रदर्शन पहले सोपान तक पहुंच गया है।
अगस्त में, बाइट के बारे में पता चला कि वह बड़ा बनने की योजना बना रहा था।
6 अगस्त को, "लेटपोस्ट" ने पहली बार खुलासा किया कि बाइट 5 ट्रिलियन से अधिक मापदंडों के साथ एक नए मॉडल के प्रशिक्षण पर चर्चा कर रहा था, जिसका नेतृत्व सीड फाउंडेशन के प्रमुख जियांग लियांग ने किया था। रिपोर्टों के अनुसार, बाइट आंतरिक रूप से यह मानता है कि मौजूदा आकार को जारी रखने के बजाय, पैरामीटर स्केल को अपने साथियों की तुलना में कई गुना अधिक बढ़ाना बेहतर है।
एक दिन बाद, 7 अगस्त को, एफटी ने मामले से परिचित लोगों का हवाला देते हुए रिपोर्ट दी कि बाइट द्वारा पूर्व-प्रशिक्षित नए मॉडल का पैमाना 10 ट्रिलियन मापदंडों तक पहुंच सकता है; जब रॉयटर्स ने अनुसरण किया, तो उसने इसकी तुलना एंथ्रोपिक के अत्याधुनिक माइथोस से भी की - हालांकि बाद वाले ने कभी भी पैरामीटर स्केल का खुलासा नहीं किया, उद्योग का अनुमान लगभग 8 ट्रिलियन तक पहुंच गया है। यदि बाइट का नया मॉडल 10T तक पहुंचता है, तो यह मिथोस द्वारा वर्तमान में प्रसारित पैमाने को पार कर जाएगा।
अब, अत्याधुनिक मॉडलों की चर्चा में 5T से अधिक की अत्यधिक बड़ी पैरामीटर मात्राएं बार-बार दिखाई देने लगी हैं।
आज, अलीबाबा के सीईओ वू योंगमिंग ने सार्वजनिक रूप से घोषणा की कि अगली पीढ़ी के मॉडल की योजना 5 ट्रिलियन से 10 ट्रिलियन मापदंडों को प्राप्त करने की है; डीपसीक 2T मॉडल का प्रशिक्षण कर रहा है, जबकि अनुवर्ती लक्ष्य 8T निर्धारित कर रहा है। यह समझा जा सकता है कि प्रमुख प्रयोगशाला ने एक बार फिर क्षमताओं की ऊपरी सीमा को प्रभावित करने के लिए एक बड़े कुल पैरामीटर पैमाने को एक महत्वपूर्ण मार्ग माना है।
यहां तक कि अमेरिकी बंद-स्रोत मॉडल जो मापदंडों का खुलासा नहीं करते हैं वे बाहरी जांच से बच नहीं सकते हैं। बाहरी लोगों द्वारा एन्थ्रोपिक के मिथोस का अनुमान 8T है; GPT-4 युग के बाद से OpenAI ने मॉडल स्केल का खुलासा नहीं किया है, लेकिन समुदाय में अफवाह है कि एस्ट्रा 10T MoE तक पहुंच गया है।
गेम पैनल पर युद्ध शक्ति मूल्य की तरह, मापदंडों की संख्या ने कभी भी अपना आकर्षण नहीं खोया है - लोग जानते हैं कि यह हर चीज का प्रतिनिधित्व नहीं कर सकता है, लेकिन यह हमेशा सबसे सहज और दमनकारी संख्या होगी।
वास्तव में, बड़े मॉडल उद्योग को कुछ समय से मापदंडों के बारे में बात करने का शौक नहीं रहा है।
पिछले दो वर्षों में, आसवन, छोटे मॉडल, एमओई, सुदृढीकरण सीखना और अनुमान समय गणना में बदलाव आया है। यह दिखाने के बजाय कि उनके पास सैकड़ों अरबों या खरबों पैरामीटर हैं, मॉडल निर्माता प्रदर्शन, लागत और दक्षता के बारे में बात करने के लिए अधिक इच्छुक हैं। बस मॉडल को बड़ा बनाने से यह आसानी से दिखने लगेगा कि आपके पास पैसा है लेकिन इसे खर्च करने के लिए कोई जगह नहीं है।
आज, पैरामीटर मात्राएं फिर से बढ़ा दी गई हैं और एक बार फिर अत्याधुनिक मॉडलों का "मोर्चा" बन गया है।
हालाँकि, आज के 5टी, 8टी, और 10टी अब स्केलिंग के पिछले दौर में "अधिक पैरामीटर, जितना बड़ा मॉडल" के समान नहीं हैं।
पैरामीटर मात्राओं को वापस तालिका में रखने का सबसे सीधा कारण यह है कि अल्ट्रा-बड़े मॉडलों की मुख्यधारा की वास्तुकला बदल गई है।
अतीत में, बड़े मॉडलों की मुख्यधारा सघन वास्तुकला थी, जहां पैरामीटर पैमाने और गणना राशि मूल रूप से एक साथ बंधे थे। सीधे शब्दों में कहें तो इसका मतलब है कि मॉडल में कितने पैरामीटर हैं, और उन्हें मूल रूप से हर गणना में एक साथ दर्ज करना होगा। जितने अधिक पैरामीटर होंगे, क्षमताओं की ऊपरी सीमा उतनी ही अधिक होगी, लेकिन प्रशिक्षण और अनुमान की लागत भी बढ़ जाती है।
आजकल, अधिक से अधिक बड़े मॉडल MoE, विशेषज्ञों के मिश्रण और मिश्रित विशेषज्ञ वास्तुकला का उपयोग करते हैं।
यह कई विशेषज्ञों वाली कंपनी की तरह है। मॉडल में सैकड़ों या हजारों विशेषज्ञ हो सकते हैं, लेकिन उनमें से केवल एक छोटा सा हिस्सा ही प्रत्येक कार्य पर काम करने के लिए चुना जाता है। उदाहरण के लिए, किमी K3 में कुल पैरामीटर 2.8T हैं, लेकिन प्रत्येक टोकन केवल 104B सक्रिय करता है, लगभग 3.7%; डीपसीक V4-प्रो में कुल 1.6T पैरामीटर हैं, और प्रत्येक टोकन केवल 49B, लगभग 3% सक्रिय करता है।
इसलिए आज, यदि किसी मॉडल में 5टी, 8टी या यहां तक कि 10टी पैरामीटर हैं, तो इसका मतलब यह नहीं है कि उसे हर बार टोकन उत्पन्न करते समय इन 10टी मापदंडों के माध्यम से चलना होगा।
मॉडल कितना धारण कर सकता है और हर बार कितनी गणना करने की आवश्यकता है, यह दो अलग-अलग संख्याएँ बन गई हैं।
पैरामीटर को मॉडल द्वारा ज्ञान, पैटर्न और क्षमताओं को ले जाने के लिए उपयोग की जाने वाली जगह के रूप में समझा जा सकता है। कुल पैरामीटर जितना बड़ा होगा, सैद्धांतिक रूप से मॉडल को अधिक से अधिक जटिल वितरण सीखने के लिए उतनी ही अधिक जगह होगी; MoE जरूरत पड़ने पर केवल उनमें से कुछ को ही कॉल करने की अनुमति देता है।
परिणामस्वरूप, मॉडल साल-दर-साल प्रत्येक गणना को भारी बनाए बिना कुल पैरामीटर क्षमता में वृद्धि जारी रख सकता है।
अभी भी K3 को एक उदाहरण के रूप में लेते हुए, इसका कुल पैरामीटर 2.8T है, जो K2.5 के पैमाने का लगभग तीन गुना है, लेकिन 896 विशेषज्ञों के बीच, प्रत्येक टोकन में से केवल 16 ही सक्रिय हैं। डार्क साइड ऑफ़ द मून ने कहा कि विरल MoE और वास्तुशिल्प अनुकूलन की एक श्रृंखला के लिए धन्यवाद, K2 की तुलना में K3 की समग्र स्केलिंग दक्षता में लगभग 2.5 गुना सुधार हुआ है।
एजेंट युग ने इस "क्षमता" को फिर से प्रतिस्पर्धा के केंद्र में धकेल दिया है।
अतीत में, चैटबॉट की क्षमता को अक्सर एक-एक करके मापा जाता था। गणित गणित को देखता है, कोड कोड को देखता है, और प्रश्नोत्तर ज्ञान को देखता है। यदि मॉडल कई प्रमुख बेंचमार्क पर उच्च शिखर तक पहुंचता है, तो यह साबित करने के लिए पर्याप्त है कि यह बहुत मजबूत है।
लेकिन एजेंट इन क्षमताओं को एक ही कार्य श्रृंखला में जोड़ता है। एक वास्तविक लंबा कार्य जानकारी की खोज से शुरू हो सकता है, फिर वेब पेज पढ़ें, चित्र देखें, कोड लिखें, टर्मिनल पर कॉल करें, और फिर त्रुटियों का सामना करें, योजना को संशोधित करें, अन्य टूल को कॉल करें और यहां तक कि अन्य एजेंटों को उप-कार्य भी सौंपें।
जब ओपनएआई ने इस साल सितंबर में एजेंट्स एपीआई जारी किया, तो उसने सीधे तौर पर लंबी अवधि के रनिंग, संदर्भ प्रबंधन, टूल उपयोग और उप-एजेंट समन्वय को एजेंट के मुख्य बुनियादी ढांचे के रूप में सूचीबद्ध किया, और इस बात पर जोर दिया कि एजेंट को घंटों या यहां तक कि दिनों तक विश्वसनीय रूप से चलने की जरूरत है।
प्रश्नोत्तर में, यदि एक निश्चित क्षमता कभी-कभी विफल हो जाती है, तो केवल एक प्रश्न खो सकता है; दर्जनों या सैकड़ों चरणों वाले एजेंट कार्य में, कोई भी कमजोर लिंक पूरे लिंक को बाधित कर सकता है। कार्य जितना लंबा होगा, क्षमता कवरेज और स्थिरता की आवश्यकताएं उतनी ही अधिक होंगी। परिणामस्वरूप, सीमांत प्रतिस्पर्धा का स्पष्ट "बैरल प्रभाव" होना शुरू हो गया है।
METR अब एजेंट क्षमताओं को मापने के लिए सीधे "कार्य समय अवधि" का भी उपयोग करता है, क्योंकि कार्य जितना लंबा होगा, मॉडल के लिए विभिन्न कार्यों की एक श्रृंखला को लगातार पूरा करने की आवश्यकता उतनी ही अधिक होगी।
चैटबॉट युग में, क्षमताओं के शिखर को देखना आसान है, जबकि एजेंट युग में, क्षमता कवरेज तेजी से महत्वपूर्ण है।
इस समय, बड़ी पैरामीटर क्षमता का नया मान होता है। कार्य जितना लंबा होगा, मॉडल उतना ही कम पक्षपाती होगा; एजेंट जितनी अधिक चीजें कर सकता है, आधार को उतनी ही व्यापक क्षमताओं को कवर करने की आवश्यकता होती है।
एमओई क्षमता के निरंतर विस्तार के लिए जगह खोलता है, और एजेंट क्षमता के मूल्य को और बढ़ाता है। इसलिए, मॉडल निर्माता मापदंडों को फिर से 5T, 8T और 10T पर धकेलते हुए दक्षता में सुधार करने की पूरी कोशिश कर रहे हैं।
बचाई गई कंप्यूटिंग शक्ति ने स्केलिंग को गायब नहीं किया, बल्कि स्केलिंग के लिए नई जगह बनाई।
टिप्पणियाँ