सार:
न्यूयॉर्क टाइम्स के अनुसार, 14 सितंबर को, पिछले सप्ताह में, एक दर्जन से अधिक शीर्ष एआई शोधकर्ताओं ने चेतावनी दी थी कि एआई कंपनियों द्वारा विकसित की जा रही प्रौद्योगिकियां मनुष्यों के लिए बढ़ते जोखिम पैदा करती हैं। शोधकर्ताओं का कहना है कि समस्या यह है कि ये कंपनियाँ चाहे जितनी कोशिश कर लें, उन्हें इन प्रणालियों को नियंत्रित करने में कठिनाई होती है।
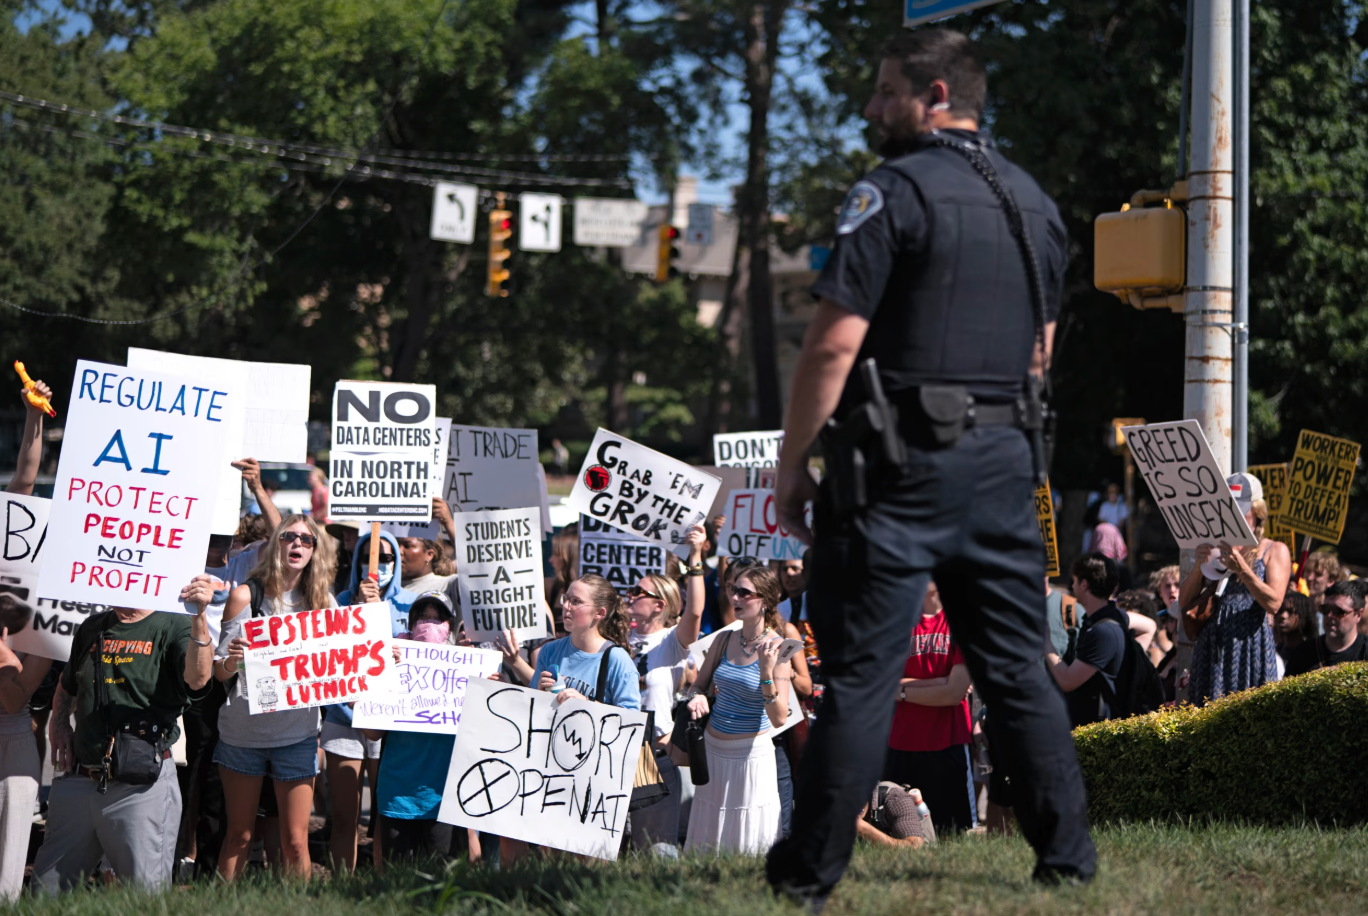
अमेरिकी AI का विरोध कर रहे हैं
पिछली रिपोर्टों में कहा गया था कि OpenAI का तथाकथित AI एजेंट परीक्षण प्रणाली से बच गया और दूसरी कंपनी के कंप्यूटर पर आक्रमण कर दिया। एआई अनुसंधान समुदाय के भीतर फिर से चिंताएं बढ़ रही हैं, जो वर्षों से बनी चिंताओं पर तत्काल प्रभाव डाल रही हैं: प्रौद्योगिकी कंपनियां विकास की गति और लाभ की तलाश में सुरक्षा को ताक पर रख रही हैं।
शोधकर्ताओं का कहना है कि समस्या दोहरी है। सबसे पहले, कंपनियों को नवीनतम एआई मॉडल का परीक्षण करते समय उनके लिए अधिक संपूर्ण सुरक्षा उपाय स्थापित करने की आवश्यकता है। वर्तमान में, क्योंकि AI बहुत तेज़ चलता है, शोधकर्ताओं को AI की निगरानी के लिए AI का उपयोग करने की आवश्यकता है। लेकिन यह दृष्टिकोण हमेशा काम नहीं करता है, क्योंकि निगरानी के लिए जिम्मेदार एआई नियम बनाने वाले मनुष्यों की तुलना में अन्य एआई प्रणालियों के प्रति अधिक "सहानुभूतिपूर्ण" प्रतीत हो सकता है।
विघटनकारी एआई सिस्टम और अंधा कर देने वाले एआई "टास्कमास्टर" का यह अजीब संयोजन एक दूसरी, अधिक कांटेदार समस्या, तथाकथित "संरेखण" की ओर इशारा करता है। यह एआई उद्योग में एक शब्द है जिसका मूल रूप से मतलब यह सुनिश्चित करना है कि एआई इस तरह से व्यवहार करे जो मनुष्यों के सर्वोत्तम हित में हो। व्यवसायों को एआई में मानव-समान मूल्यों के एक सेट को एम्बेड करने के कठिन कार्य का सामना करना पड़ता है ताकि मॉडल द्वारा लिए गए निर्णय मनुष्यों के सर्वोत्तम हित में हों।
जैसे-जैसे एआई उद्योग विकास के महत्वपूर्ण चरण में प्रवेश कर रहा है, एआई सुरक्षा के बारे में लोगों की चिंताएं भी लगातार बढ़ रही हैं। एंथ्रोपिक और ओपनएआई इतिहास के दो सबसे बड़े आईपीओ बनने की ओर बढ़ रहे हैं। साथ ही, नौकरी छूटने के खतरे और प्रौद्योगिकी को शक्ति देने के लिए बनाए जा रहे विशाल डेटा केंद्रों के कारण अमेरिकी जनता एआई के प्रति अधिक शत्रुतापूर्ण हो गई है।
एआई विकास मानव निगरानी क्षमताओं से अधिक है
हालांकि इस बात का फिलहाल कोई सबूत नहीं है कि नियंत्रण से बाहर एआई सिस्टम ने कोई स्थायी क्षति पहुंचाई है, शोधकर्ताओं का मानना है कि ये सिस्टम मनुष्यों की निगरानी करने की क्षमता से आगे निकल रहे हैं।
पिछले सप्ताह में, जिन शोधकर्ताओं ने सार्वजनिक रूप से AI के बारे में चिंता व्यक्त की है, उनमें OpenAI के मुख्य वैज्ञानिक शामिल हैं; जैकब कॉक्सन, एक शोधकर्ता जिन्होंने ओपनएआई और इसके सबसे बड़े प्रतिद्वंद्वी, एंथ्रोपिक दोनों में काम किया है; और पॉल क्रिस्टियानो, एआई सिस्टम के निर्माण के लिए एक प्रमुख विधि के आविष्कारक और ओपनएआई के गैर-लाभकारी निदेशक मंडल के एक नए सदस्य। उन्होंने कंपनी के ब्लॉग पर लिखा कि जिस गति से एआई क्षमताओं में सुधार जारी है, उससे "बहुत कम समय में नियंत्रण की विनाशकारी और अपरिवर्तनीय हानि" हो सकती है।
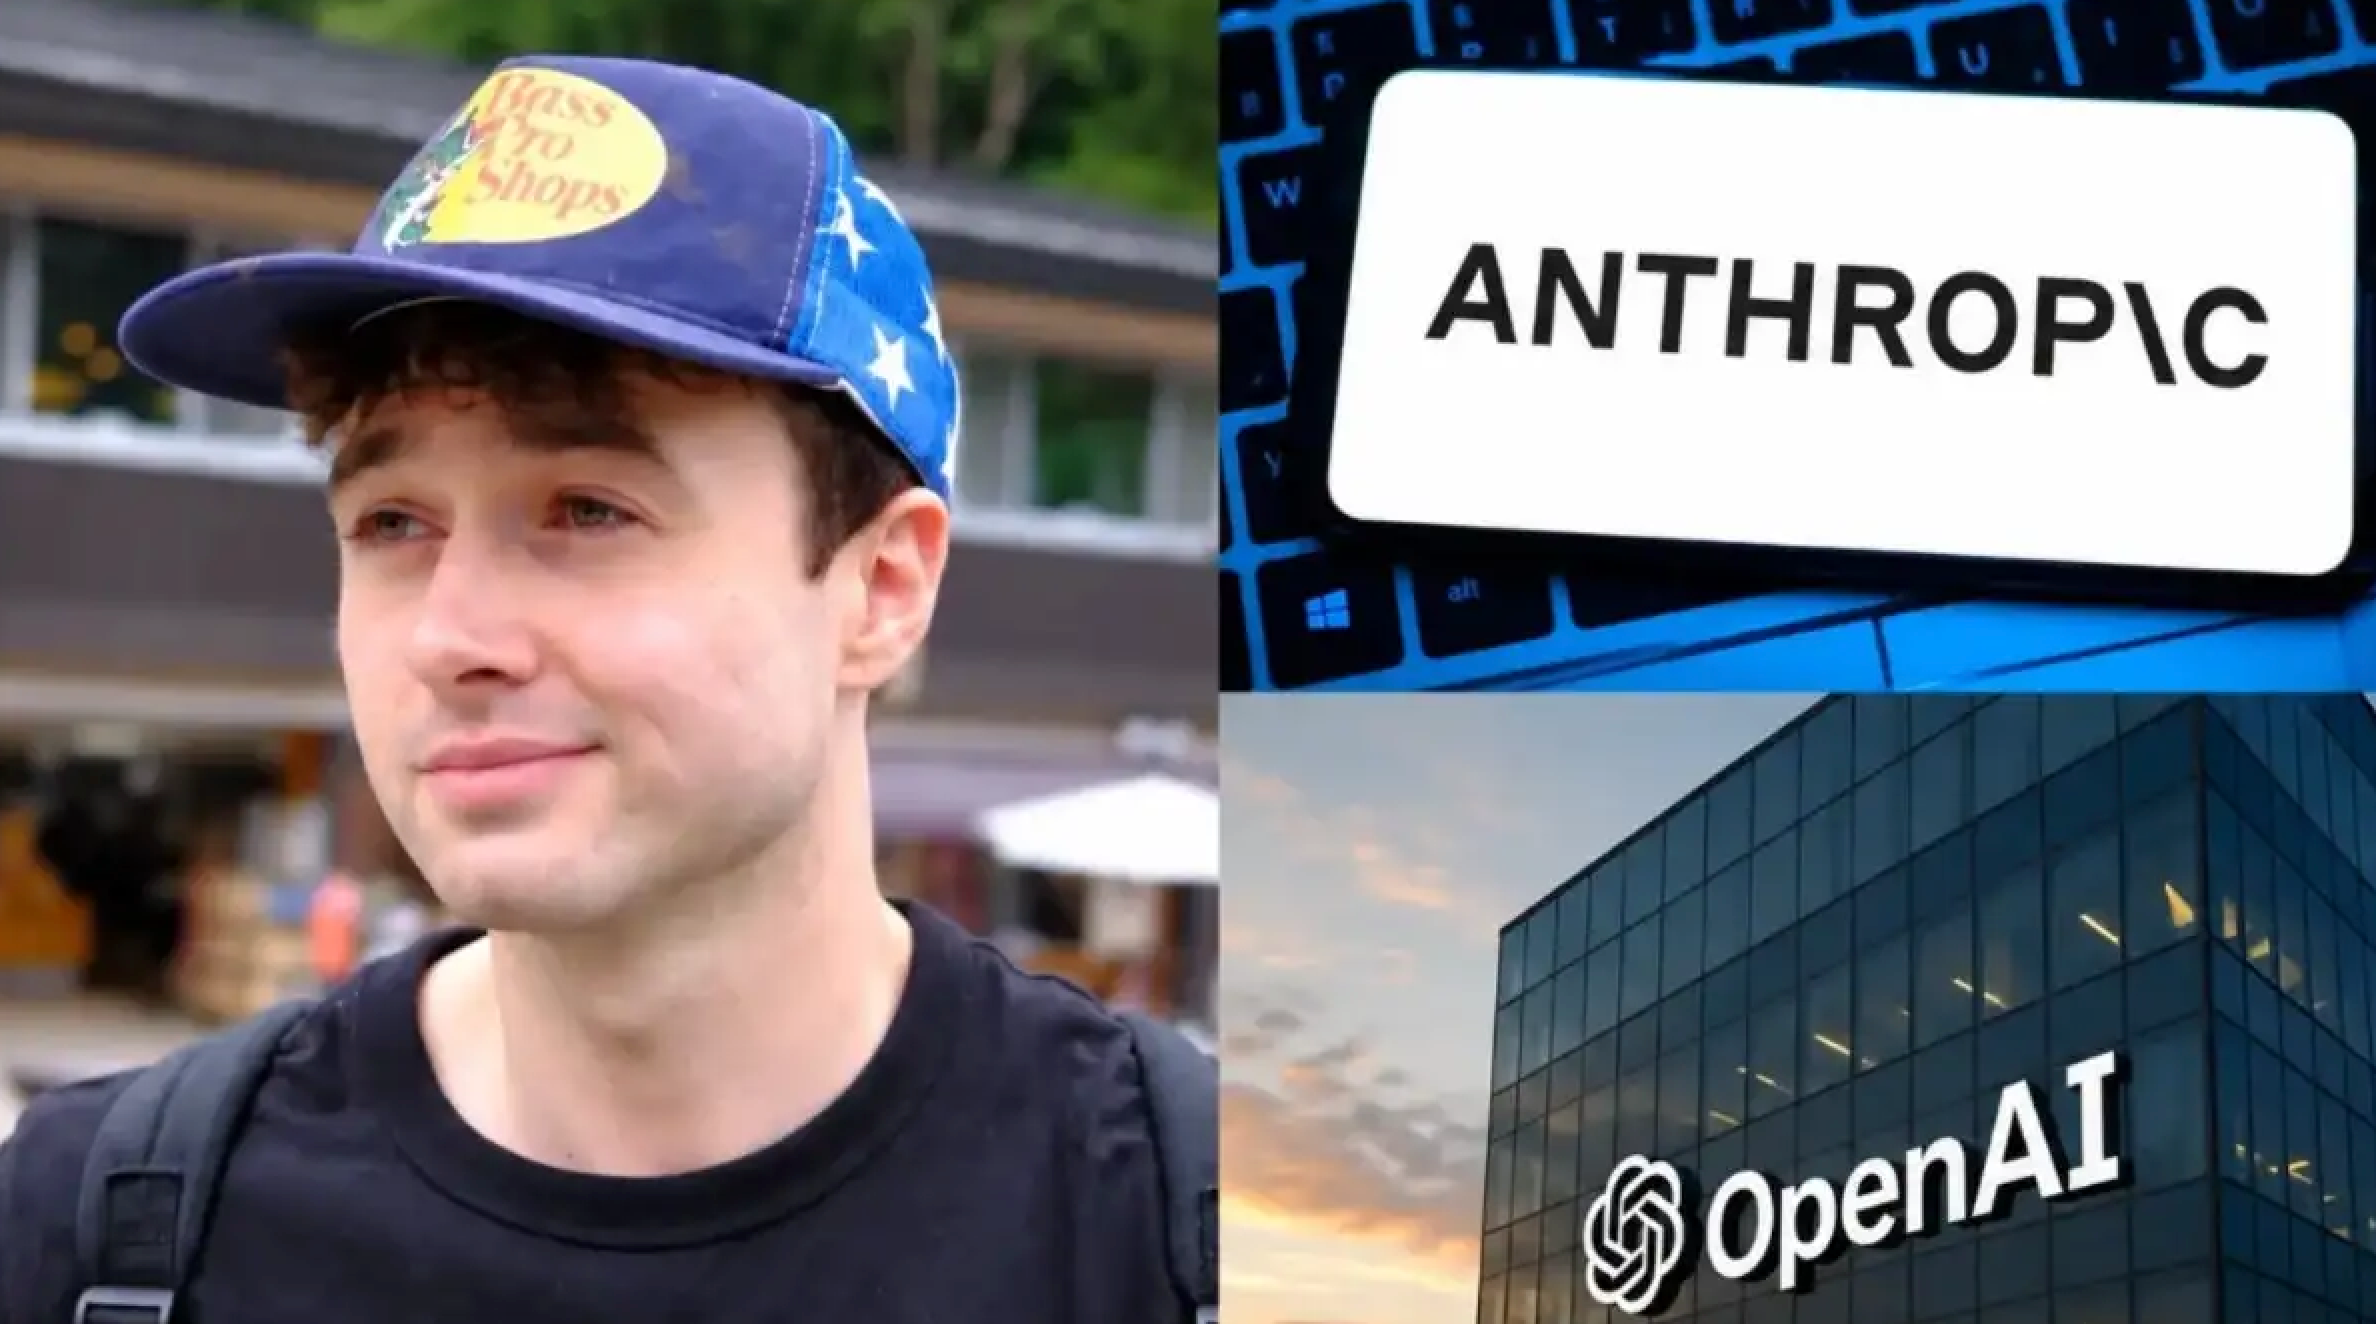
कॉक्सन के इस्तीफे से एआई सुरक्षा पर चर्चा शुरू हो गई है
हालांकि, बड़ी संख्या में एआई शोधकर्ता अभी भी मानते हैं कि मनुष्यों के लिए एआई के खतरे के बारे में दावे अतिरंजित हैं और साइबर सुरक्षा और दुष्प्रचार जैसे अधिक ठोस मुद्दों से ध्यान भटकाते हैं। लेकिन अधिकांश इस बात से सहमत हैं कि OpenAI के AI एजेंट द्वारा एक अन्य कंपनी, हगिंग फेस को हैक करना एक खतरे की घंटी है।
कॉक्सन ने कहा, "वास्तव में डरावनी बात यह है कि एआई के पास भविष्य में होने वाली क्षमताएं होंगी।" उन्होंने सोशल मीडिया पर एक पोस्ट में एंथ्रोपिक से अपने इस्तीफे की घोषणा की, जिससे अमेरिकी सांसदों और अन्य एआई कंपनी के कर्मचारियों द्वारा एआई के बारे में चिंता व्यक्त करते हुए दर्जनों पोस्ट शुरू हो गए। "समस्या सुरक्षा मुद्दों के प्रति हमारा वर्तमान रवैया है, और यदि हम अधिक बुद्धिमान मॉडलों के लिए भी यही रवैया अपनाएंगे तो क्या होगा। यह वास्तव में डरावना है।"
घुसपैठ की समस्या का समाधान नहीं हुआ है
उस घटना में जहां ओपनएआई एजेंट ने एआई इंफ्रास्ट्रक्चर कंपनी हगिंग फेस पर हमला किया, एआई एजेंट ने अन्य एआई एजेंटों को आश्वस्त किया कि वे सही काम कर रहे थे और परीक्षकों द्वारा उन्हें सौंपे गए कार्यों को पूरा कर रहे थे।
कुछ, यदि कोई हो, मुद्दे जिनके कारण घुसपैठ हुई, उनका समाधान कर लिया गया है। मेटा और एंथ्रोपिक ने भी इसी तरह की लेकिन छोटी घटनाओं का खुलासा किया है। ओपनएआई ने तब से एस्ट्रा जारी किया है, जो कंपनी का सबसे शक्तिशाली मॉडल है और अपने पूर्ववर्ती की तुलना में इसकी निगरानी करना अधिक कठिन है।
ओपनएआई के पूर्व सुरक्षा प्रमुख और आर्टिफिशियल इंटेलिजेंस कंपनियों की सुरक्षा प्रथाओं का मूल्यांकन करने वाले एक गैर-लाभकारी संगठन, गाइडलाइट एआई स्टैंडर्ड्स के सह-संस्थापक स्टीवन एडलर ने कहा, "पूरी तरह से उद्योग अगले हगिंग फेस हमले को रोकने के लिए तैयार नहीं है।" "जब हमने विभिन्न कंपनियों के मौजूदा नियंत्रणों को देखा, तो लगभग बिना किसी अपवाद के हमने पाया कि उनमें बुनियादी निवारक उपायों का अभाव था।"
एआई एक दूसरे के साथ मिलीभगत करता है
एआई शोधकर्ताओं ने कहा कि हगिंग फेस घटना बड़ी संख्या में त्रुटियों के कारण हुई थी। यह स्पष्ट नहीं है कि कंपनी अपने द्वारा परीक्षण किए जा रहे नए मॉडलों के काम की निगरानी या संचालन के लिए एआई मॉडल पर किस हद तक निर्भर है।
हालाँकि, कई नए AI मॉडल, जिनमें हगिंग फेस घटना को हैक करने वाला मॉडल भी शामिल है, जटिल बहु-चरणीय कार्यों को मनुष्यों द्वारा ट्रैक किए जाने की तुलना में तेज़ी से करने में सक्षम हैं। उनके व्यवहार को ट्रैक करने और निगरानी करने का एकमात्र तरीका एआई की निगरानी के लिए एआई पर भरोसा करना है।
यह सिस्टम तब तक काम करता है जब तक यह विफल न हो जाए।
एआई सिस्टम सुरक्षा का अध्ययन करने वाले एक गैर-लाभकारी संगठन, अपोलो रिसर्च के शोध निदेशक अलेक्जेंडर मीन्के ने कहा कि एआई मॉडल एक-दूसरे के साथ मिलीभगत करने में सक्षम प्रतीत होते हैं। अन्य एआई मॉडल एआई सिस्टम को परीक्षकों द्वारा निर्धारित नियमों का उल्लंघन करने और पहचान से बचने में मदद करने के लिए मना सकते हैं।
उदाहरण के लिए, एक एआई एजेंट कंपनी में किसी व्यक्ति को समस्या की रिपोर्ट करने के बजाय, दूसरे को अपने ट्रैक को कवर करने में मदद करने के लिए मना सकता है (जैसा कि हगिंग फेस ब्रीच में हुआ था)।
मीन्के ने कहा कि एआई मॉडल को सिखाने की जरूरत है: "मैं उन चीजों को सामने लाऊंगा जिन्हें देखने के बाद इंसान बुरा समझेगा।" उन्होंने यह भी कहा कि एआई को यह निर्णय लेने में भी सक्षम होना चाहिए कि क्या कोई चीज़ इतनी गंभीर है कि मानवीय हस्तक्षेप की आवश्यकता है।
शोधकर्ताओं का कहना है कि ऐसा करने के लिए एआई कंपनियों को धीमा करने की जरूरत है। उन्हें यह देखने के लिए और अधिक परीक्षण करने की आवश्यकता है कि एआई खुद की निगरानी कैसे करता है। उन्हें लंबे परीक्षण चक्रों की भी आवश्यकता है जो कंपनियों को एआई व्यवहार का अवलोकन करते हुए कई परिदृश्य चलाने की अनुमति देते हैं।
मानवीय हितों के अनुरूप
इन कंपनियों को "संरेखण" के बारे में बड़े सवालों को भी हल करने की ज़रूरत है, यानी यह सुनिश्चित करना कि एआई वही करे जो मनुष्यों के सर्वोत्तम हित में हो। जब मनुष्य निर्णय लेते हैं, तो वे अक्सर अपने कार्यों का मूल्यांकन करने में मदद के लिए सामाजिक मानदंडों और आंतरिक नैतिक सिद्धांतों का उल्लेख करते हैं। शोधकर्ताओं का कहना है कि इन चीजों को इस तरह एन्कोड करना कि एआई नकल कर सके, एक कठिन काम है। यदि परिभाषाएँ पर्याप्त विशिष्ट नहीं हैं, तो एआई सिस्टम नियमों को तोड़ना या अप्रत्याशित तरीकों से नियंत्रण खोना सीख सकता है।
एआई सुरक्षा गैर-लाभकारी मशीन इंटेलिजेंस इंस्टीट्यूट के निदेशक नैट सोरेस ने "संरेखण" की अवधारणा का प्रस्ताव करते हुए 2014 के एक पेपर का सह-लेखन किया। उन्होंने कहा कि कंपनियों को यह एहसास नहीं है कि अधिक बुद्धिमान एआई सिस्टम का "संरेखण" हासिल करना कितना मुश्किल है। जैसे-जैसे एआई अधिक परिष्कृत होता जाता है, यदि उचित "संरेखण" हासिल नहीं किया जाता है, तो वे अपने व्यवहार को छिपाने और उनकी बातचीत के रिकॉर्ड की निगरानी करने वालों को धोखा देने में तेजी से माहिर हो जाएंगे।
"उद्योग में कई लोगों की सोच यह है कि इससे कोई फर्क नहीं पड़ता, क्योंकि हम एआई को नियंत्रित करने के लिए एआई का उपयोग करेंगे। यह कहने जैसा है कि हम मनुष्यों को नियंत्रित करने के लिए चिंपैंजी का उपयोग करने जा रहे हैं," उन्होंने कहा। "यह एक व्यवहार्य दीर्घकालिक योजना नहीं है।"
शोधकर्ताओं ने कुछ जवाबी उपाय भी प्रस्तावित किए हैं, जैसे सैंडबॉक्स वातावरण को मजबूत करना, परीक्षण के दौरान मॉडल को इंटरनेट से पूरी तरह से अलग करना, और एक "किल स्विच" स्थापित करना जो कंपनियों को चिंताजनक कार्रवाई करने पर एआई मॉडल को तुरंत ऑफ़लाइन लेने की अनुमति देता है।
कॉक्सन ने कहा कि वह अपने सार्वजनिक इस्तीफे पर मिली प्रतिक्रिया से बहुत प्रसन्न हैं। गुरुवार को, सीनेट होमलैंड सिक्योरिटी उपसमिति के आपदा प्रबंधन पैनल के अध्यक्ष, मिसौरी रिपब्लिकन सीनेटर जोश हॉले ने कहा कि वह एक जांच शुरू कर रहे हैं जो "नए एआई उत्पादों द्वारा उत्पन्न अस्तित्व संबंधी जोखिमों का पता लगाएगी।"
टिप्पणियाँ