
सार:
एप्पल की शोध टीम ने रोबोट "मस्तिष्क" पर शोध में प्रगति का खुलासा किया। 4 नवंबर को, स्थानीय समय में, Apple अनुसंधान टीम ने प्रीप्रिंट प्लेटफ़ॉर्म arXiv पर "सिमुलेशन से परसेप्टिव ह्यूमनॉइड मोशन" पेपर प्रस्तुत किया, जिसमें ह्यूमनॉइड रोबोट स्वायत्त नियंत्रण प्रणाली HALO का खुलासा किया गया। अनुसंधान टीम ने सत्यापन के लिए युशु टेक्नोलॉजी के जी1 ह्यूमनॉइड रोबोट पर सिस्टम तैनात किया, जिससे रोबोट को सिमुलेशन वातावरण में सीखी गई गतिविधियों को करने और उन्हें एक अपरिचित वास्तविक जीवन वाले कमरे में निष्पादित करने की अनुमति मिली।
अनुसंधान टीम ने एक्शन जेनरेशन, एक्शन ट्रैकिंग, टास्क ऑर्केस्ट्रेशन, सिमुलेशन और वास्तविक रोबोट ऑपरेशन को कवर करते हुए डेटा जेनरेशन, मॉडल प्रशिक्षण और परिनियोजन कोड का भी खुलासा किया।
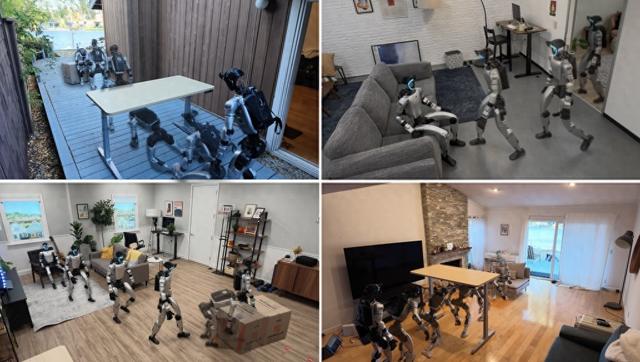
द युशू HALO सिस्टम से लैस G1 रोबोट टेबल के नीचे रेंगने, सोफे पर बैठने और विभिन्न वास्तविक वातावरणों में बक्सों को धकेलने जैसे कार्यों को प्रदर्शित करता है। छवि स्रोत: HALO अनुसंधान टीम
प्रोजेक्ट पेज में रोबोट को बक्से को धक्का देने, लोगों का अनुसरण करने, कुर्सियों पर बैठने, आधे खुले दरवाजे के माध्यम से किनारे पर बैठने, मेज के नीचे झुकने या रेंगने आदि के निर्देशों का पालन करते हुए दिखाया गया है। इन कार्यों के लिए रोबोट को अपने परिवेश को समझने और स्थानिक स्थितियों के अनुसार अपने शरीर की मुद्रा को समायोजित करने की आवश्यकता होती है।
कार्य निष्पादित करते समय, HALO को तीन स्तरों द्वारा सहयोगात्मक रूप से नियंत्रित किया जाता है। शीर्ष परत दृश्य भाषा मॉडल (वीएलएम) पर आधारित कार्य ऑर्केस्ट्रेशन मॉड्यूल है। यह डिफ़ॉल्ट रूप से Qianwen Qwen3.6-35B-A3B का उपयोग करता है। यह रोबोट से सुसज्जित मैक मिनी पर स्थानीय रूप से चलता है। यह मॉडल सर्विस इंजन को एक्शन जनरेटर के साथ साझा करता है और इंटरनेट कनेक्शन की आवश्यकता के बिना काम कर सकता है। सिस्टम मजबूत तर्क और योजना क्षमताओं को प्राप्त करने के लिए एपीआई के माध्यम से क्लाउड मॉडल को कॉल करना भी चुन सकता है।
इस परत को निर्देशों में अस्पष्ट जानकारी को संसाधित करने और पर्यावरण के अनुसार कार्यों को व्यवस्थित करने की आवश्यकता है। उदाहरण के लिए, "बैठ जाओ" का कोई स्पष्ट रूप से निर्दिष्ट लक्ष्य नहीं है और रोबोट को यह निर्धारित करने की आवश्यकता है कि उसके सामने के दृश्य से कहाँ बैठना है; रास्ता साफ होने पर "कुर्सी पर बैठो" को सीधे निष्पादित किया जा सकता है, लेकिन अगर कोई मेज रास्ता रोक रही है, तो इसे लगातार उप-कार्यों में विभाजित करना होगा जैसे कि झुकना, कुर्सी के पास आना और बैठना। कार्य ऑर्केस्ट्रेशन मॉड्यूल लगातार रोबोट के दृष्टिकोण से वीडियो के माध्यम से पर्यावरण का निरीक्षण करता है, यह निर्धारित करता है कि वर्तमान कार्रवाई सफल है या नहीं, और योजना को आगे बढ़ाता है या तदनुसार पुनः प्रयास करता है, हर बार एक्शन जनरेटर को एक स्पष्ट उप-कार्य जारी करता है।
बीच में एक्शन जेनरेशन परत एक अन्य Qianwen मॉडल Qwen3.5-2B का उपयोग करती है। अनुसंधान टीम इसे एक पैरामीटर-फ्रीजिंग एनकोडर के रूप में उपयोग करती है और रोबोट द्वारा देखी गई तस्वीरों और वर्तमान उप-कार्य के आधार पर भविष्य में लगभग 5 सेकंड के लिए पूरे शरीर की गतिविधियों की योजना बनाने के लिए क्रियाएं उत्पन्न करने के लिए जिम्मेदार डीआईटी डिकोडर के साथ सहयोग करती है। इस परत को प्रति सेकंड लगभग तीन बार पुन: नियोजित किया जाता है, जिससे वातावरण में परिवर्तन होने पर कार्य योजना को लगातार अद्यतन किया जा सकता है।
नीचे की परत एक एक्शन ट्रैकर है जिसे सुदृढीकरण सीखने, नीति आसवन और अन्य चरणों के माध्यम से प्रशिक्षित किया गया है। यह प्रति सेकंड 50 बार की आवृत्ति पर चलता है, गहराई की छवियों और रोबोट की अपनी स्थिति को जोड़ता है, और कार्य योजनाओं को संयुक्त नियंत्रण निर्देशों में परिवर्तित करता है।
तीनों स्तर क्रमशः कार्य व्यवस्था, कार्य योजना और निकाय नियंत्रण के लिए जिम्मेदार हैं, और निर्देशों को समझने से लेकर कार्यों को निष्पादित करने तक की प्रक्रिया को सहयोगात्मक रूप से पूरा करते हैं।
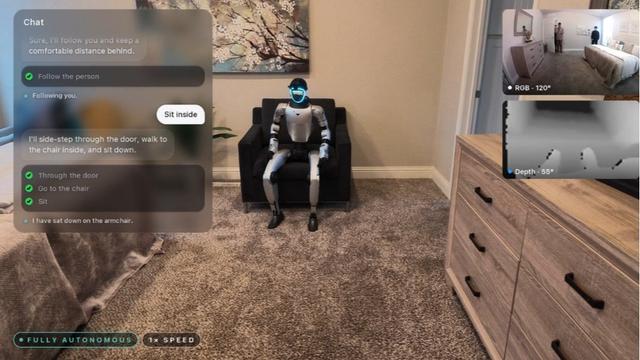

HALO की तीन-परत नियंत्रण वास्तुकला: दृश्य भाषा मॉडल कार्य ऑर्केस्ट्रेशन के लिए जिम्मेदार है, पीढ़ी मॉड्यूल पूरे शरीर के आंदोलनों की योजना बनाता है, और सुदृढीकरण सीखने द्वारा प्रशिक्षित एक्शन ट्रैकर संयुक्त नियंत्रण करता है। छवि स्रोत: HALO प्रोजेक्ट पेज
से स्क्रीनशॉट का मोज़ेकपेपर के अनुसार, अनुसंधान टीम ने पूर्व-स्कैनिंग या मैपिंग के बिना 6 वास्तविक वातावरणों में 360 एकल कार्य परीक्षण किए, जिनकी औसत सफलता दर 91% थी। एक अन्य वास्तविक वातावरण में, तीन संयुक्त कार्यों पर 10 परीक्षण किए गए, और औसत सफलता दर 70% थी। उनमें से, "बाधा पर झुकना - लक्ष्य की ओर चलना - बॉक्स को धक्का देना" के संयोजन की सफलता दर 50% है।
रोबोट इन कार्यों को पूरा करने के लिए आवश्यक डेटा कैसे प्राप्त करते हैं, इस शोध का केंद्र बिंदु है। अनुसंधान टीम ने "रोबोट ने क्या देखा", "उसे क्या निर्देश प्राप्त हुए" और "कैसे आगे बढ़ना है" से मेल खाने के लिए 1,000 प्रोग्राम-जनरेटेड सिम्युलेटेड घरेलू वातावरण में लगभग 300 घंटे के प्राथमिक प्रशिक्षण डेटा को संश्लेषित किया।
विशेष रूप से, सिस्टम पहले क्रियाएं उत्पन्न करता है, फिर क्रियाओं को वर्चुअल रूम में डालता है, और अंत में रोबोट के परिप्रेक्ष्य से छवियां उत्पन्न करता है। प्रोजेक्ट पेज एक उदाहरण के रूप में "आर्मचेयर पर बैठें" को लेता है, इसे आगे चलने, चारों ओर घूमने और बैठने जैसे खंडों में विभाजित करता है। एक्शन जेनरेशन मॉडल टेक्स्ट प्रॉम्प्ट, वे पॉइंट और मुख्य मुद्राओं के आधार पर एक्शन सीक्वेंस उत्पन्न करता है। पैर फिसलने और शरीर के जमीन में घुसने जैसी समस्याओं को कम करने के लिए गतिविधियों को ज्यामितीय जांच के माध्यम से जांचा जाता है।
फिर, सिस्टम प्रोग्राम-जनरेटेड रूम में क्रियाओं को व्यवस्थित करता है, रोबोट और फर्नीचर के बीच स्थितीय संबंध की जांच करता है, टकराव-मुक्त प्लेसमेंट योजना की तलाश करता है, और फिर रोबोट जब कार्रवाई करता है तो उसे देखने के लिए सिमुलेशन टूल का उपयोग करता है। प्रशिक्षण के दौरान, दृश्य इनपुट को अधिक विविध बनाने के लिए प्रकाश व्यवस्था, रंग टोन और छवि धुंधला जैसी स्थितियों को भी बदला जाएगा। इस तरह, वही प्रक्रिया निर्देश, दृश्य चित्र और पूरे शरीर की गतिविधियों सहित सहायक डेटा उत्पन्न कर सकती है।
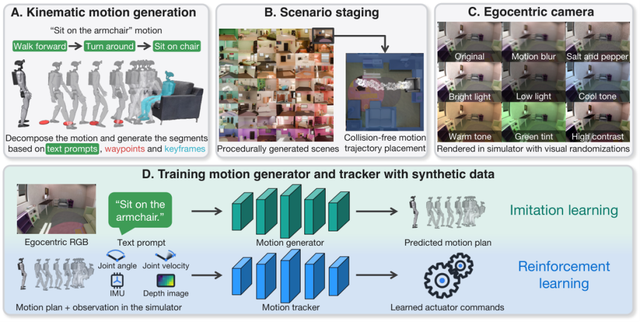
HALO की सिंथेटिक डेटा पीढ़ी और प्रशिक्षण प्रक्रिया: पहले एक एक्शन प्रक्षेपवक्र उत्पन्न करें, इसे आभासी दृश्य में डालें, और फिर एक्शन जनरेटर और एक्शन ट्रैकर के प्रशिक्षण के लिए सहायक प्रशिक्षण डेटा बनाने के लिए रोबोट के परिप्रेक्ष्य से छवि प्रस्तुत करें। छवि स्रोत: हेलो पेपर
रिपोर्टों के अनुसार, अनुसंधान टीम ने 250 NVIDIA H100 GPU का उपयोग किया और मुख्य प्रशिक्षण डेटा को संश्लेषित करने में लगभग 48 घंटे लगे। एक्शन जनरेटर को 64 बी200 का उपयोग करके अनुकरण शिक्षण के माध्यम से प्रशिक्षित किया जाता है; एक्शन ट्रैकर को 4 H100 का उपयोग करके सुदृढीकरण सीखने, नीति आसवन और अन्य चरणों के माध्यम से प्रशिक्षित किया जाता है।
यह बताया जाना चाहिए कि सिमुलेशन द्वारा उत्पन्न डेटा पूरी तरह से मानव भागीदारी से छुटकारा नहीं दिलाता है। टीम ने कहा कि नए भौतिक कार्यों में अभी भी त्वरित शब्दों के मैन्युअल लेखन और एक्शन कुंजी फ़्रेमों के डिज़ाइन की आवश्यकता होती है, और कुछ कार्यों में मानव वीडियो या मोशन कैप्चर सामग्री का भी उपयोग किया जाता है।
शोध टीम ने यह भी बताया कि वर्तमान में रोबोट मुख्य रूप से दृश्य धारणा पर निर्भर हैं और संपर्क स्थितियों को सीधे समझना मुश्किल है; जब वस्तुएं कैमरे के दृश्य क्षेत्र को छोड़ देती हैं या अवरुद्ध हो जाती हैं, तो अधिक संपर्कों वाले कार्यों के प्रदर्शन में गिरावट आएगी। स्पर्श संबंधी धारणा को जोड़ना बाद के सुधारों की दिशाओं में से एक है।
टिप्पणियाँ