सार:
विंडोज उपयोगकर्ताओं के लिए जो अपने कंप्यूटर पर कृत्रिम बुद्धिमत्ता मॉडल चलाना चाहते हैं, स्थानीय एआई टूल को स्थापित करने और कॉन्फ़िगर करने के लिए हमेशा एक निश्चित सीमा होती है। उपयोगकर्ताओं को न केवल उपयुक्त मॉडल फ़ाइलें ढूंढने की ज़रूरत है, बल्कि मॉडल प्रारूप, हार्डवेयर संगतता, अनुमान इंजन स्थापना और स्टार्टअप पैरामीटर जैसे मुद्दों पर भी विचार करना होगा। आज, हगिंग फेस और llama.cpp टीमों से संबंधित डेवलपर्स द्वारा लॉन्च किया गया विंडोज के लिए ओपन सोर्स एप्लिकेशन लामा, इस प्रक्रिया को कुछ सरल ऑपरेशनों में सरल बनाने का प्रयास करता है, जिससे उपयोगकर्ताओं को कमांड लाइन का उपयोग किए बिना विंडोज कंप्यूटर पर स्थानीय बड़े भाषा मॉडल डाउनलोड करने और चलाने की अनुमति मिलती है।
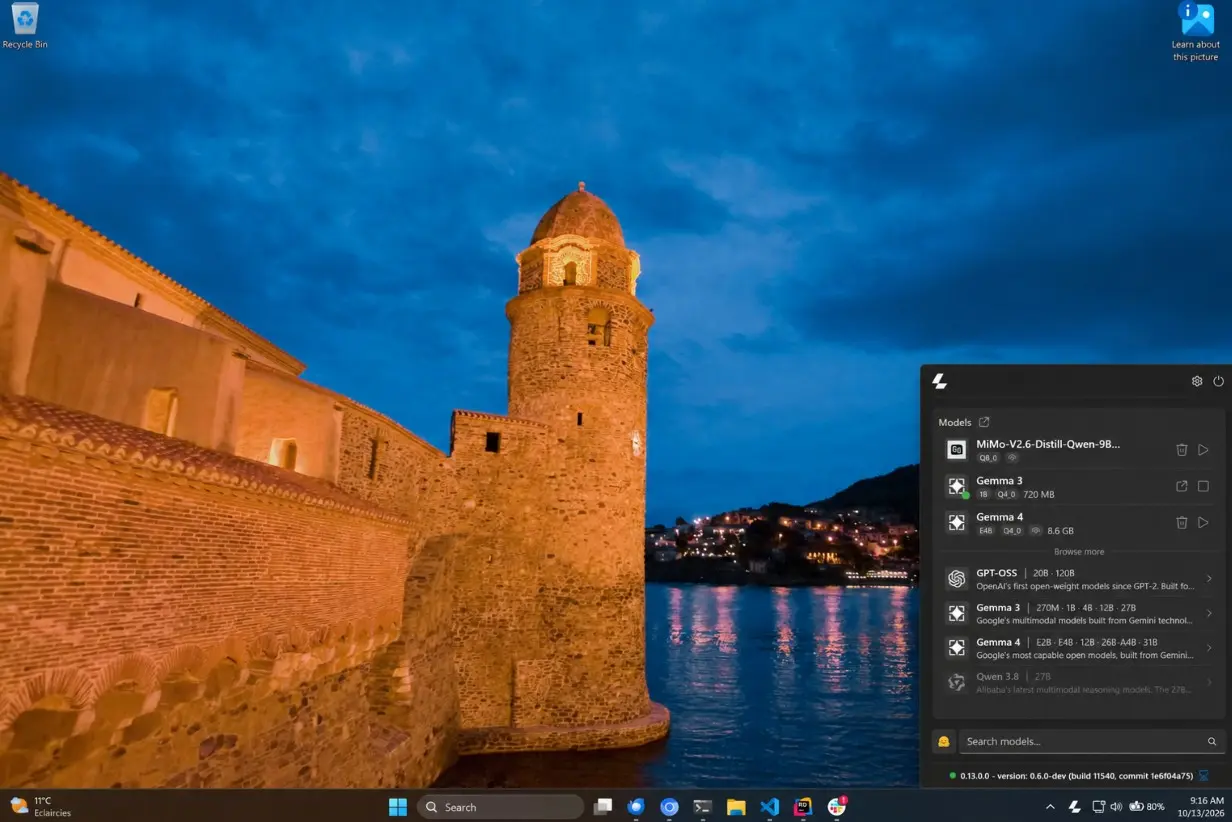
Windows के लिए Llama अक्टूबर 2026 में लॉन्च किया जाएगा और यह Llama एप्लिकेशन के macOS संस्करण का Windows समकक्ष है। यह एक मुफ़्त, ओपन सोर्स विंडोज़ 11 एप्लिकेशन है जो माइक्रोसॉफ्ट की WinUI 3 तकनीक पर बनाया गया है और मुख्य रूप से सिस्टम नोटिफिकेशन क्षेत्र में चलता है। उपयोगकर्ता इसे इंस्टॉल करने के बाद, पारंपरिक सॉफ़्टवेयर की तरह एक स्वतंत्र विंडो रखे बिना, टास्कबार के अधिसूचना क्षेत्र में एप्लिकेशन आइकन के माध्यम से नियंत्रण कक्ष खोल सकते हैं।
इस एप्लिकेशन की सबसे महत्वपूर्ण विशेषता हगिंग फेस मॉडल वेयरहाउस से सीधे जुड़ने की इसकी क्षमता है। हगिंग फेस वर्तमान में ओपन सोर्स आर्टिफिशियल इंटेलिजेंस मॉडल के लिए एक महत्वपूर्ण होस्टिंग प्लेटफॉर्म है, जो विभिन्न विकास टीमों से बड़ी संख्या में मॉडल और उनके व्युत्पन्न संस्करणों को एक साथ लाता है। अतीत में, उपयोगकर्ताओं को आमतौर पर स्वयं एक उपयुक्त मॉडल फ़ाइल ढूंढनी होती थी, यह निर्धारित करना होता था कि फ़ाइल प्रारूप सही है या नहीं, फिर संबंधित संस्करण डाउनलोड करें और इसे अनुमान इंजन के माध्यम से शुरू करें। औसत उपयोगकर्ता के लिए जो कृत्रिम बुद्धिमत्ता तकनीक से परिचित नहीं है, यह प्रक्रिया काफी कठिन हो सकती है।
विंडोज़ के लिए लामा एप्लिकेशन के भीतर अनुशंसित मॉडलों की एक सूची प्रदान करता है। उपयोगकर्ता मॉडल के पैरामीटर आकार, डिस्क स्थान की जांच कर सकते हैं, और क्या यह छवि समझ जैसे दृश्य कार्यों का समर्थन करता है, और फिर डाउनलोड करने के लिए अपने कंप्यूटर के लिए उपयुक्त मॉडल का चयन कर सकते हैं। मॉडल का चयन करने के बाद, बस संबंधित विकल्प पर क्लिक करें और ऐप स्वचालित रूप से डाउनलोड होना शुरू हो जाएगा और डाउनलोड प्रगति प्रदर्शित करेगा।
यह उपकरण मुख्य रूप से GGUF प्रारूप में परिमाणीकरण मॉडल का उपयोग करता है। जीजीयूएफ llama.cpp पारिस्थितिकी तंत्र द्वारा संचालित है और स्थानीय स्तर पर ओपन सोर्स बड़े भाषा मॉडल चलाने के लिए व्यापक रूप से उपयोग किए जाने वाले मॉडल फ़ाइल स्वरूपों में से एक बन गया है। क्वांटिफिकेशन तकनीक मॉडल मापदंडों की संख्यात्मक सटीकता को कम करके मॉडल द्वारा आवश्यक भंडारण स्थान और रनिंग मेमोरी को कम कर सकती है, जिससे उन मॉडलों को सामान्य व्यक्तिगत कंप्यूटर पर चलने का अवसर मिलता है जिन्हें मूल रूप से उच्च हार्डवेयर कॉन्फ़िगरेशन की आवश्यकता होती है। हालाँकि, परिमाणीकरण आम तौर पर कुछ हद तक सटीकता की हानि भी लाता है, और विशिष्ट प्रभाव मॉडल, परिमाणीकरण विधि और उपयोग परिदृश्य पर निर्भर करता है।
मॉडल प्रबंधन के संदर्भ में, विंडोज़ के लिए लामा उन मॉडलों को सूचीबद्ध करेगा जिन्हें कंप्यूटर पर डाउनलोड किया गया है। उपयोगकर्ता सीधे मॉडलों को लोड या अनलोड कर सकते हैं और अंतर्निहित वेब इंटरफ़ेस के माध्यम से मॉडलों से बात कर सकते हैं। एप्लिकेशन मॉडल की वर्तमान चल रही स्थिति को भी प्रदर्शित करता है, जिससे उपयोगकर्ताओं को पृष्ठभूमि प्रक्रिया को मैन्युअल रूप से जांचने के बिना यह जानने की अनुमति मिलती है कि मॉडल शुरू किया गया है या नहीं।
अंतर्निहित अनुमान इंजन को एप्लिकेशन द्वारा स्वचालित रूप से भी नियंत्रित किया जा सकता है। विंडोज़ के लिए लामा मुख्य रनिंग घटक के रूप में llama.cpp का उपयोग करता है। यदि सिस्टम में पहले से ही प्रयोग करने योग्य llama.cpp सेवा मौजूद है, तो एप्लिकेशन मौजूदा सेवा से कनेक्ट हो सकता है; यदि यह स्थापित नहीं है, तो इसे आधिकारिक इंस्टॉलर के माध्यम से स्थापित किया जा सकता है। पूरी प्रक्रिया के लिए व्यवस्थापक अधिकारों की आवश्यकता नहीं होती है, और उपयोगकर्ताओं को स्रोत कोड को स्वयं संकलित करने या जटिल स्टार्टअप मापदंडों को मैन्युअल रूप से कॉन्फ़िगर करने की आवश्यकता नहीं होती है।
यह डिज़ाइन स्थानीय AI के लिए प्रवेश बाधा को कम करता है, लेकिन इसका मतलब यह नहीं है कि सभी मॉडल किसी भी कंप्यूटर पर आसानी से चल सकते हैं। मॉडल का वास्तविक प्रदर्शन अभी भी प्रोसेसर, मेमोरी, ग्राफिक्स कार्ड, वीडियो मेमोरी क्षमता और मॉडल के आकार पर निर्भर करता है। छोटे पैरामीटर आकार वाले मॉडल को आम तौर पर नियमित कंप्यूटर पर चलाना आसान होता है, जबकि बड़े मॉडल को अच्छी प्रतिक्रिया समय प्राप्त करने के लिए बहुत अधिक मेमोरी या उच्च-प्रदर्शन ग्राफिक्स कार्ड वाले वर्कस्टेशन की भी आवश्यकता हो सकती है।
विंडोज़ के लिए लामा सिस्टम-स्तरीय त्वरित लॉन्चर के समान एक चैट इंटरफ़ेस भी प्रदान करता है। उपयोगकर्ता फ्लोटिंग चैट विंडो लाने और वर्तमान में लोड किए गए मॉडल के साथ सीधे इंटरैक्ट करने के लिए अन्य एप्लिकेशन में Alt+Space शॉर्टकट कुंजी दबा सकते हैं। विंडो एक हल्के डिज़ाइन को अपनाती है, और बातचीत छिपने के तुरंत बाद बंद नहीं होगी, और दोबारा कॉल करने पर इसका उपयोग जारी रखा जा सकता है। इसका मतलब है कि उपयोगकर्ताओं को दस्तावेज़ लिखते समय, वेब ब्राउज़ करते समय, या कोड लिखते समय बार-बार स्टैंडअलोन एआई अनुप्रयोगों पर स्विच नहीं करना पड़ता है।
आम उपयोगकर्ताओं के लिए चैट फ़ंक्शन के अलावा, सॉफ़्टवेयर डेवलपर्स की ज़रूरतों को भी ध्यान में रखता है। एप्लिकेशन स्थानीय मशीन पर llama.cpp पर आधारित एक स्थानीय सर्वर शुरू कर सकता है और OpenAI इंटरफ़ेस के साथ संगत एपीआई के माध्यम से मॉडल सेवाएं प्रदान कर सकता है। डिफ़ॉल्ट सेवा पता
http://localhost:9931 है। डेवलपर्स अपनी स्क्रिप्ट, एप्लिकेशन या एआई एजेंट दूरस्थ क्लाउड सेवाओं को सभी अनुरोध भेजे बिना स्थानीय मॉडल को कॉल कर सकते हैं।
क्योंकि इंटरफ़ेस OpenAI API के साथ संगत है, मूल रूप से OpenAI इंटरफ़ेस के लिए विकसित किए गए कुछ टूल में सेवा पते और संबंधित कॉन्फ़िगरेशन को समायोजित करके स्थानीय रूप से चल रहे मॉडल तक पहुंचने का अवसर हो सकता है। हालाँकि, इंटरफ़ेस अनुकूलता का मतलब यह नहीं है कि सभी फ़ंक्शन पूरी तरह से सुसंगत हैं। इसका उपयोग अभी भी किया जा सकता है या नहीं यह क्लाइंट द्वारा आवश्यक एपीआई क्षमताओं पर निर्भर करता है और लोड किया गया मॉडल संबंधित कार्यों का समर्थन करता है या नहीं।
यह विंडोज के लिए लामा को न केवल एक स्थानीय चैट टूल बनाता है, बल्कि पर्सनल कंप्यूटर पर एक एआई रनिंग प्लेटफॉर्म भी बनाता है। एक ही मॉडल फ़ाइल को कई एप्लिकेशन द्वारा साझा किया जा सकता है, और डेवलपर्स को प्रत्येक प्रोग्राम के लिए एक अलग मॉडल डाउनलोड करने की आवश्यकता नहीं होती है, इस प्रकार डिस्क स्थान पर बार-बार होने वाले कब्जे को कम किया जा सकता है। यह आर्किटेक्चर उन उपयोगकर्ताओं के लिए कुछ व्यावहारिक मूल्य रखता है जो स्थानीय स्तर पर प्रोग्रामिंग सहायक, दस्तावेज़ विश्लेषण उपकरण या अन्य एआई एप्लिकेशन बनाना चाहते हैं।
गोपनीयता के संदर्भ में, स्थानीय स्तर पर मॉडल चलाने का मुख्य लाभ यह है कि अनुमान प्रक्रिया को दूरस्थ एआई सेवाओं पर निर्भर नहीं रहना पड़ता है। प्रोजेक्ट विवरण के अनुसार, उपयोगकर्ता द्वारा दर्ज किए गए त्वरित शब्द और मॉडल अनुमान मूल रूप से किए जाते हैं, और ऐप टेलीमेट्री एकत्र नहीं करता है, घटनाओं का विश्लेषण नहीं करता है, या विशेष इंस्टॉलेशन पहचानकर्ता उत्पन्न नहीं करता है। हालाँकि, मॉडल फ़ाइलों को डाउनलोड करने और सॉफ़्टवेयर अपडेट प्राप्त करने के लिए उपयोगकर्ताओं को अभी भी इंटरनेट से कनेक्ट होने की आवश्यकता है। परियोजना विवरण में यह भी उल्लेख किया गया है कि इन नेटवर्किंग अनुरोधों में एक मानक उपयोगकर्ता-एजेंट पहचान होगी जिसमें सॉफ्टवेयर संस्करण, विंडोज संस्करण और प्रोसेसर आर्किटेक्चर जैसी जानकारी शामिल होगी। इसलिए, तथाकथित स्थानीय ऑपरेशन का मतलब यह नहीं है कि संपूर्ण स्थापना और रखरखाव प्रक्रिया के लिए नेटवर्क की बिल्कुल भी आवश्यकता नहीं है, बल्कि इसका मतलब है कि मॉडल अनुमान और शीघ्र शब्द प्रसंस्करण स्थानीय रूप से रह सकता है।
हार्डवेयर संगतता भी इस ऐप का फोकस है। विंडोज़ के लिए लामा विंडोज़ 11 के x64 और ARM64 प्लेटफ़ॉर्म का समर्थन करता है और आर्म उपकरणों पर विंडोज़ के लिए मूल समर्थन प्रदान करता है। यह आर्म प्रोसेसर से लैस विंडोज नोटबुक के लिए विशेष रूप से महत्वपूर्ण है, क्योंकि कुछ स्थानीय एआई उपकरण मुख्य रूप से अतीत में पारंपरिक x86 कंप्यूटरों के लिए विकसित किए गए थे, और आर्म उपकरणों पर चलने वाले सिमुलेशन पर भरोसा करने की आवश्यकता हो सकती है, या संबंधित पूर्व-संकलित घटकों की कमी हो सकती है।
परियोजना में NVIDIA RTX स्पार्क प्लेटफ़ॉर्म के लिए समर्थन का भी उल्लेख किया गया है। प्लेटफ़ॉर्म स्थानीय एआई कंप्यूटिंग अनुप्रयोगों के लिए तैयार है और उन उपयोगकर्ताओं के लिए एक और हार्डवेयर विकल्प प्रदान कर सकता है जो डेस्कटॉप वातावरण में बड़े मॉडल चलाना चाहते हैं। हालाँकि, एक निश्चित प्लेटफ़ॉर्म का समर्थन करने वाले सॉफ़्टवेयर का मतलब यह नहीं है कि सभी मॉडल आदर्श प्रदर्शन प्राप्त कर सकते हैं। विशिष्ट ऑपरेटिंग परिणाम अभी भी मॉडल आकार, मेमोरी क्षमता और अनुमान कॉन्फ़िगरेशन पर निर्भर करते हैं।
विंडोज़ के लिए लामा को लामा की आधिकारिक वेबसाइट के माध्यम से प्राप्त किया जा सकता है, या आप प्रोजेक्ट के GitHub रिलीज़ पेज से संबंधित इंस्टॉलेशन पैकेज डाउनलोड कर सकते हैं। एक बार इंस्टॉल हो जाने पर, उपयोगकर्ता ऐप खोल सकते हैं, एक मॉडल का चयन कर सकते हैं, डाउनलोड पूरा होने तक प्रतीक्षा कर सकते हैं और फिर फ्लोटिंग चैट विंडो या वेब इंटरफ़ेस के माध्यम से इसका उपयोग शुरू कर सकते हैं। यह ध्यान दिया जाना चाहिए कि ऐप वर्तमान में विंडोज 11 के लिए है और विंडोज 10 को समर्थित प्लेटफॉर्म के रूप में सूचीबद्ध नहीं करता है।
सामान्य तौर पर, विंडोज़ के लिए लामा स्थानीय बड़े भाषा मॉडलों की रनिंग तकनीक का पुन: आविष्कार नहीं करता है, बल्कि मूल रूप से मॉडल वेयरहाउस, अनुमान इंजन और कमांड लाइन टूल्स में बिखरे हुए चरणों को एक हल्के इंटरफ़ेस में एकीकृत करता है। इसका सबसे बड़ा मूल्य स्थानीय एपीआई और डेवलपर वर्कफ़्लो जैसी स्केलेबिलिटी क्षमताओं को बनाए रखते हुए उपयोग की सीमा को कम करने में निहित है।
जैसे-जैसे ओपन सोर्स मॉडल का विकास जारी है, एआई को स्थानीय स्तर पर चलाना धीरे-धीरे एक टॉस-अप प्रोजेक्ट से बदल रहा है जिसके लिए एक एप्लिकेशन परिदृश्य में कुछ तकनीकी अनुभव की आवश्यकता होती है जिसे सामान्य कंप्यूटर उपयोगकर्ता आज़मा सकते हैं। विंडोज़ के लिए लामा एक मुख्यधारा उपकरण बन सकता है या नहीं, यह इसकी स्थिरता, मॉडल समर्थन सीमा और वास्तविक चलने के अनुभव पर निर्भर करता है, लेकिन यह कम से कम विंडोज़ उपयोगकर्ताओं के लिए इसे आसान बनाता है: वे पहले जटिल कमांड लाइन संचालन सीखने के बिना अपने कंप्यूटर पर एआई मॉडल चलाने की खोज शुरू कर सकते हैं।
डाउनलोड पता:
https://llama.app/download/windows
https://github.com/ggml-org/Llama-Windows
टिप्पणियाँ