सार:
आर्टिफिशियल इंटेलिजेंस स्टार्टअप आर्किटेक्ट लैब्स का दावा है कि इसके प्रायोगिक फ्रॉस्टबाइट सीपीयू आर्किटेक्चर में पारंपरिक प्रोसेसर कोर की तुलना में प्रति वाट 4.59 गुना अधिक प्रदर्शन और प्रति यूनिट क्षेत्र 8.77 गुना अधिक प्रदर्शन है। आर्टिफिशियल इंटेलिजेंस का उपयोग करके स्क्रैच से डिज़ाइन किया गया, फ्रॉस्टबाइट कंप्यूटिंग के लिए एक बिल्कुल अलग दृष्टिकोण लेता है, लेकिन इसके प्रभावशाली परिणामों को अभी तक वास्तविक चिप पर सत्यापित नहीं किया गया है।
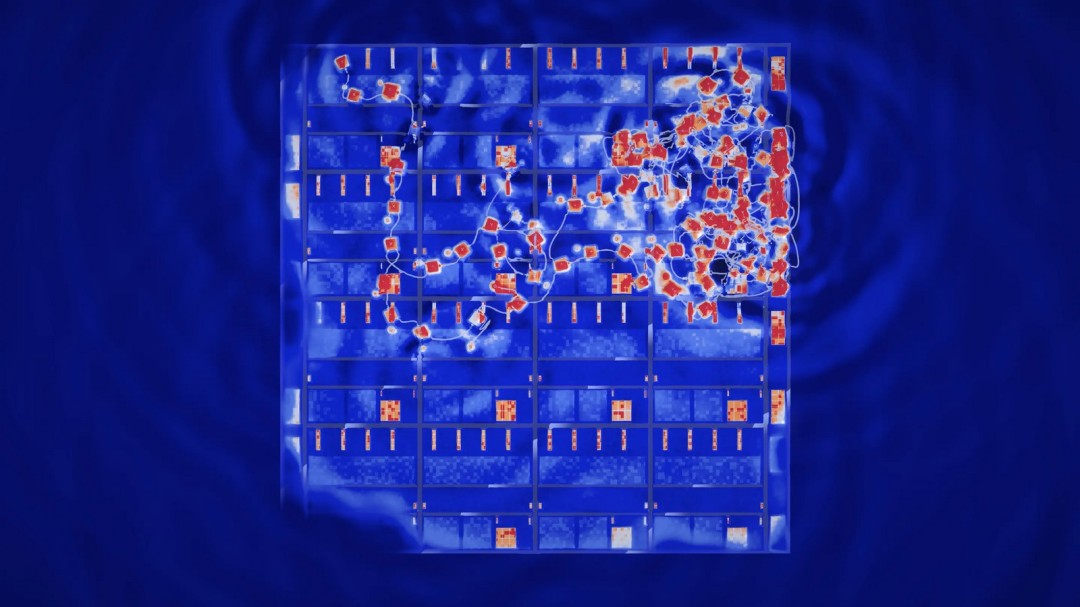
आर्किटेक्ट लैब्स, एक अमेरिकी आर्टिफिशियल इंटेलिजेंस स्टार्टअप, का दावा है कि उसके आर्टिफिशियल इंटेलिजेंस सिस्टम ने स्क्रैच से एक नया सामान्य प्रयोजन सीपीयू आर्किटेक्चर डिजाइन किया है, जिसमें निर्देश सेट, माइक्रोआर्किटेक्चर, आरटीएल कोड, सत्यापन और अंतिम जीडीएस लेआउट शामिल हैं। कंपनी का दावा है कि 25 वर्कलोड के तहत, इसके नए डिज़ाइन का प्रति वाट प्रदर्शन पारंपरिक सीपीयू कोर का 4.59 गुना है, और प्रति यूनिट क्षेत्र इसका प्रदर्शन पारंपरिक सीपीयू कोर का 8.77 गुना है। हालाँकि, ये परिणाम प्री-चिप निर्माण सिमुलेशन से आते हैं, वास्तविक भौतिक प्रोसेसर से नहीं।
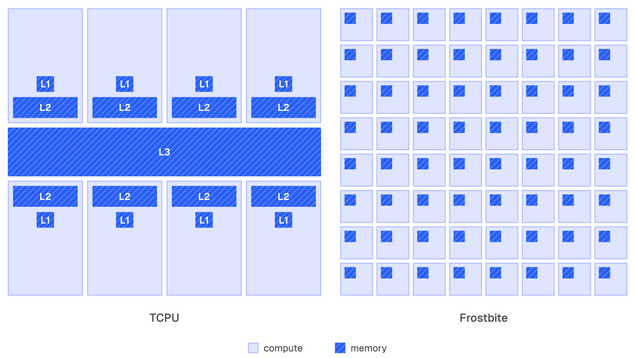
पारंपरिक सीपीयू के विपरीत, फ्रॉस्टबाइट आर्किटेक्चर इंटरेक्शननेट्स नामक एक गणितीय मॉडल पर आधारित है, जिसे पहली बार 1990 में प्रस्तावित किया गया था। एक बड़े कोर पर निर्भर होने के बजाय, यह छोटी कंप्यूटिंग इकाइयों के ग्रिड का उपयोग करता है जो इंटरेक्शन नेटवर्क के रूप में प्रस्तुत कार्यक्रमों को निष्पादित करता है: एक इंटरेक्शन नेटवर्क एक ग्राफ है जिसमें कनेक्टेड नोड्स के स्थानीय पुनर्लेखन द्वारा गणना की जाती है। प्रत्येक कंप्यूटिंग इकाई पहले अपने कार्यों को संसाधित करती है और निष्क्रिय होने पर पड़ोसी कंप्यूटिंग इकाइयों से अतिरिक्त कार्य प्राप्त करती है। यदि करने के लिए कोई काम नहीं है, तो बिजली बचाने के लिए यह निष्क्रिय अवस्था में जा सकता है। यह वितरित दृष्टिकोण एक केंद्रीकृत अनुसूचक की आवश्यकता को समाप्त करता है और वास्तुकला को अधिक स्केलेबल बनाने के लिए डिज़ाइन किया गया है।
आर्किटेक्ट लैब्स का कहना है कि यह दृष्टिकोण साझा परिवर्तनीय मेमोरी, जटिल कैश पदानुक्रम और कैश सुसंगतता तंत्र की आवश्यकता को भी कम करता है। प्रत्येक मान का केवल एक स्वामी होता है, और गणना कनेक्टेड नोड्स के बीच स्थानीय इंटरैक्शन के माध्यम से की जाती है। प्रोग्राम कंपनी द्वारा विकसित वाइन भाषा में रस्ट के समान सिंटैक्स के साथ लिखे जाते हैं, और आइवी नामक एक मध्यवर्ती प्रतिनिधित्व में संकलित किए जाते हैं।
कंपनी ने कहा कि उसके एआई सिस्टम ने कंपाइलर, इंस्ट्रक्शन सेट, आर्किटेक्चर, माइक्रोआर्किटेक्चर, आरटीएल, सत्यापन और अंतिम जीडीएस लेआउट में पुनरावृत्ति करते हुए "आर्किटेक्चर के शून्य पूर्व ज्ञान" के साथ आर्किटेक्चर का पता लगाया। इस प्रक्रिया में औपचारिक, मशीन-सत्यापन योग्य विशिष्टताओं और बहु-एजेंट समूहों का उपयोग किया गया, जिसमें खोज के चार दौर और परीक्षण के अंतिम दौर में कुल 58 प्रस्तावों पर विचार किया गया। आर्किटेक्ट लैब्स ने कहा कि 37 प्रस्तावों को अंततः बरकरार रखा गया।
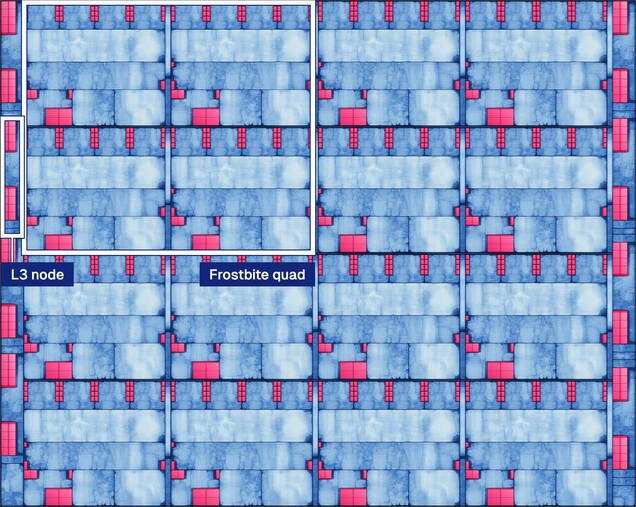
फ्रॉस्टबाइट के 7nm लेआउट में 4×4 ग्रिड है, जो 2×2 फ्रॉस्टबाइट क्वाड और L3 नोड को हाइलाइट करता है
प्रदर्शन मूल्यांकन के लिए, आर्किटेक्ट लैब्स ने 7nm प्रक्रिया का उपयोग करके फ्रॉस्टबाइट कोर को संश्लेषित किया। संश्लेषण प्रक्रिया के दौरान डिज़ाइन 800 मेगाहर्ट्ज की आवृत्ति तक पहुंच गया और अंतिम भौतिक लेआउट 500 मेगाहर्ट्ज था। फ्रॉस्टबाइट क्वाड में 2×2 ग्रिड और चार L3 कैश नोड्स में व्यवस्थित चार कंप्यूटिंग इकाइयाँ होती हैं, जिनका क्षेत्रफल 0.792 वर्ग मिलीमीटर होता है। तुलनात्मक सीपीयू कोर (जिसे कंपनी टीसीपीयू कहती है) समान प्रक्रिया प्रौद्योगिकी का उपयोग करती है और इसका क्षेत्रफल 0.895 वर्ग मिलीमीटर है। कानूनी कारणों से, आर्किटेक्ट लैब्स प्रतिद्वंद्वी प्रोसेसर की पहचान का खुलासा नहीं कर रहा है।
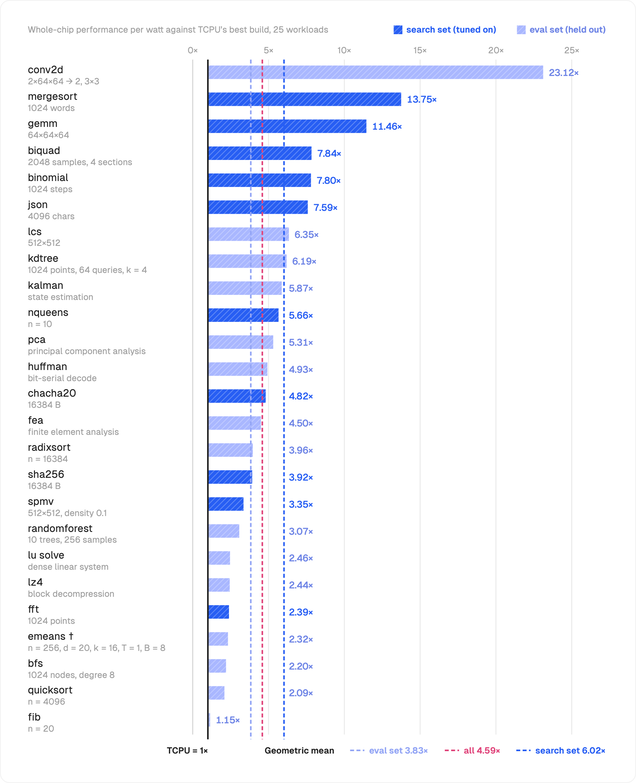
25 कार्यभार परीक्षणों में, फ्रॉस्टबाइट आर्किटेक्चर ने संदर्भ सीपीयू कोर की तुलना में प्रति वाट 4.59 गुना ज्यामितीय माध्य प्रदर्शन हासिल किया। अनुकूलन प्रक्रिया के दौरान उपयोग किए गए 10 कार्यभार परीक्षणों में लाभ 6.02x तक पहुंच गया और अंतिम मूल्यांकन से पहले बनाए गए 15 कार्यभार परीक्षणों में 3.83x तक पहुंच गया। कंपनी ने प्रति इकाई क्षेत्र में 8.77 गुना तक प्रदर्शन लाभ की भी सूचना दी।
फ्रॉस्टबाइट आर्किटेक्चर का प्रति वाट प्रदर्शन 25 वर्कलोड के तहत पारंपरिक सीपीयू की तुलना में कैसा है? धराशायी रेखाएँ खोज सेट, होल्ड-आउट सेट और सभी कार्यभार के ज्यामितीय माध्य का प्रतिनिधित्व करती हैं।
आर्किटेक्ट लैब्स ने कहा कि प्रदर्शन में सुधार कम मेमोरी ट्रैफ़िक और निर्देश ओवरहेड से आता है। कार्यभार के आधार पर परीक्षण के परिणाम काफी भिन्न होते हैं। फ्रॉस्टबाइट अत्यधिक समानांतर कार्यों पर विशेष रूप से अच्छा प्रदर्शन करता है, और आर्किटेक्ट लैब्स ने यह भी नोट किया कि यह ब्रांचिंग और गतिशील वर्कलोड पर संदर्भ कोर से भी बेहतर प्रदर्शन करता है। कंपनी उद्योग-मानक SPEC और PARSEC बेंचमार्क को शामिल करने के लिए परीक्षण का विस्तार करने और उनकी तुलना बड़े, व्यापक, आउट-ऑफ-ऑर्डर CPU डिज़ाइनों से करने की योजना बना रही है।
हालांकि परिणाम उत्साहजनक हैं, फ्रॉस्टबाइट आर्किटेक्चर अभी भी प्रायोगिक चरण में है और बड़े पैमाने पर उत्पादित प्रोसेसर नहीं है। आर्किटेक्ट लैब्स ने फ्रॉस्टबाइट चिप के बड़े पैमाने पर उत्पादन या लॉन्च की योजना की घोषणा नहीं की है। कंपनी की योजना आरटीएल और इंस्ट्रक्शन सेट आर्किटेक्चर (आईएसए) जारी करने, एफपीजीए-आधारित सॉफ्टवेयर टेस्ट प्लेटफॉर्म बनाने, प्रारंभिक ऑपरेटिंग सिस्टम विकसित करने और मल्टी-कोर सीपीयू के साथ बड़े फ्रॉस्टबाइट कॉन्फ़िगरेशन के प्रदर्शन की तुलना करने के लिए स्पेक और पारसेक जैसे उद्योग-मानक बेंचमार्किंग टूल का उपयोग करने की है।
टिप्पणियाँ