सार:
डेवलपर द्वारा पूरा किए गए एक प्रयोग से पता चलता है कि अनुकूलित सॉफ़्टवेयर के माध्यम से iPhone 17 प्रो मैक्स को M4 प्रो चिप से लैस मैकबुक प्रो से जोड़ने से स्थानीय बड़े भाषा मॉडल की ऑपरेटिंग दक्षता में काफी सुधार हो सकता है। Qwen3.8-27B मॉडल चलाते समय, सिस्टम का प्रीफ़िल प्रदर्शन 44% तक बेहतर हो जाता है।
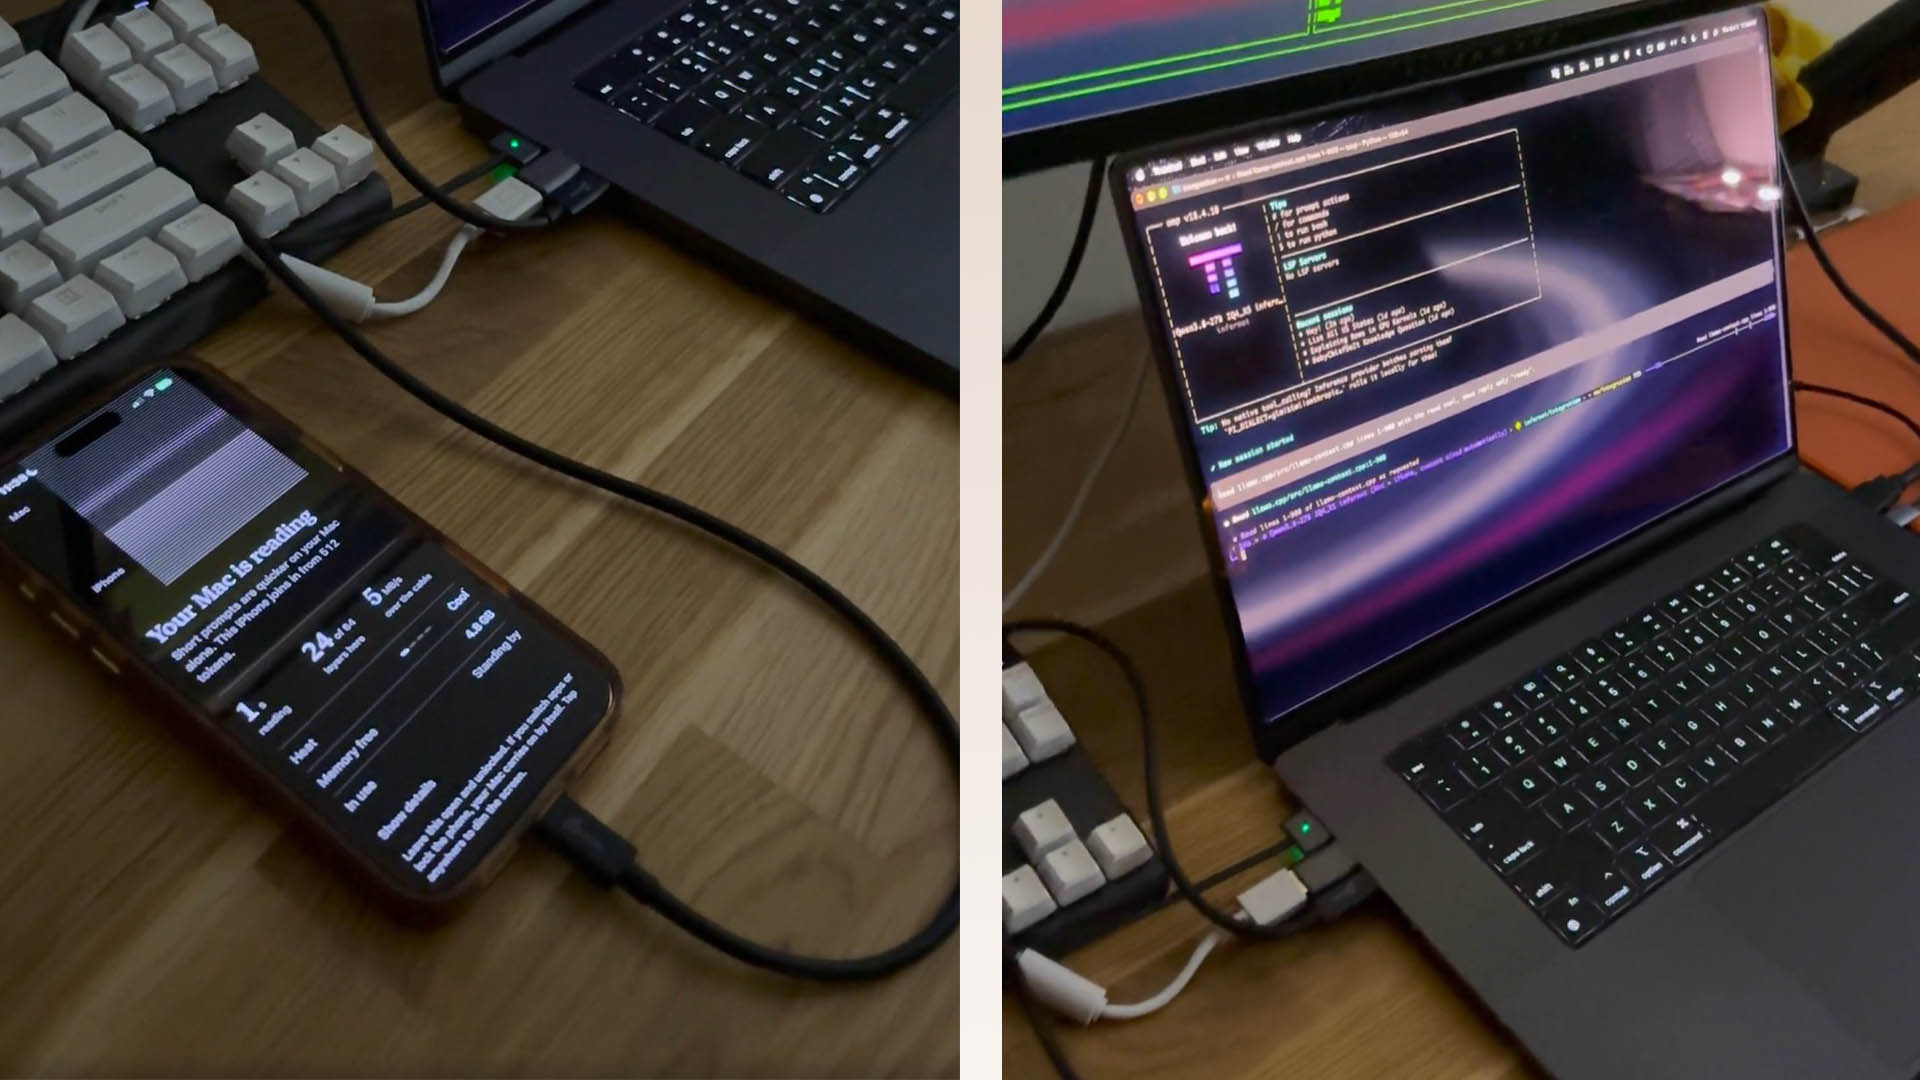
इस प्रयोग की पृष्ठभूमि यह है कि बड़े भाषा मॉडल की वीडियो मेमोरी और सिस्टम मेमोरी क्षमता पर अत्यधिक आवश्यकताएं होती हैं। हालाँकि M4 प्रो चिप से लैस मैकबुक प्रो में 24GB की एकीकृत मेमोरी है, 27 बिलियन पैरामीटर स्तरों के साथ एक बड़े मॉडल को चलाने पर यह अभी भी मेमोरी क्षमता और संदर्भ विंडो आकार द्वारा सीमित है। इसलिए डेवलपर्स ने USB-C इंटरफ़ेस के माध्यम से मैकबुक प्रो के साथ संयोजन में मॉडल चलाने के लिए एक अतिरिक्त कंप्यूटिंग नोड के रूप में iPhone 17 प्रो मैक्स का उपयोग करने का प्रयास किया।
डेवलपर द्वारा घोषित योजना के अनुसार, मैकबुक प्रो प्रत्येक 256 टोकन बैच में परत 1 से परत 40 तक कंप्यूटिंग कार्यों को संसाधित करने के लिए ज़िम्मेदार है, और वास्तविक समय में मध्यवर्ती सक्रियण डेटा को आईफोन में प्रसारित करता है। इसके बाद, iPhone 17 Pro Max लेयर 41 से लेयर 64 ऑपरेशन जारी रखने के लिए A19 Pro चिप में GPU का उपयोग करता है, जबकि Mac एक साथ डेटा के अगले बैच को प्रोसेस करना शुरू कर देता है। श्रम के इस पाइपलाइन विभाजन के माध्यम से, दो उपकरण एक ही समय में मॉडल अनुमान प्रक्रिया में भाग ले सकते हैं।
प्रायोगिक नतीजे बताते हैं कि केवल मैकबुक प्रो पर मॉडल चलाने की तुलना में, आईफोन पेश करने के बाद प्री-फिलिंग गति में काफी सुधार हुआ है। 8K संदर्भ विंडो के तहत, प्रसंस्करण गति 132 टोकन प्रति सेकंड से बढ़कर 177 टोकन हो जाती है, जो 35% की वृद्धि है; 16K संदर्भ विंडो के तहत, प्रदर्शन 109 टोकन प्रति सेकंड से बढ़कर 157 टोकन हो जाता है, 44% की वृद्धि; 32K संदर्भ विंडो परिदृश्य में, प्रसंस्करण गति 101 टोकन प्रति सेकंड से बढ़कर 130 टोकन हो जाती है, जो लगभग 29% की वृद्धि है।
GPU सहयोगी कंप्यूटिंग के अलावा, A19 प्रो चिप में तंत्रिका नेटवर्क इंजन भी कुछ कार्यों में भाग लेता है। डेवलपर्स ने कहा कि प्रत्येक 16K ऐतिहासिक संदर्भ को प्रसंस्करण के लिए एक समर्पित तंत्रिका नेटवर्क मॉडल में परिवर्तित किया जाएगा। 140,000 टोकन संदर्भ पैमाने पर, केवल GPU पर निर्भर होने पर एकल टोकन का लेखन समय 279 मिलीसेकंड से कम होकर 176 मिलीसेकंड हो जाता है, जिससे लंबे संदर्भ परिदृश्यों में ऑपरेटिंग दक्षता में और सुधार होता है।
हालाँकि, यह समाधान सीमाओं से रहित नहीं है। डेवलपर्स ने बताया कि iPhone मुख्य रूप से प्री-फिलिंग चरण के प्रदर्शन को बेहतर बनाने में मदद करता है, जबकि 64K से नीचे के टेक्स्ट जेनरेशन कार्यों में, अधिकांश वास्तविक तर्क कार्य अभी भी मुख्य रूप से मैक द्वारा किया जाता है। इसके अलावा, इस समाधान के लिए विशेष रूप से विकसित सॉफ़्टवेयर समर्थन की आवश्यकता है और वर्तमान में यह सामान्य उपयोगकर्ताओं द्वारा सीधे तैनाती के लिए उपयुक्त नहीं है।
फिर भी, यह प्रयोग स्थानीय AI कंप्यूटिंग के लिए उपभोक्ता-ग्रेड Apple उपकरणों की क्षमता को प्रदर्शित करता है। जैसे-जैसे मोबाइल चिप्स के प्रदर्शन में सुधार जारी है, भविष्य में स्मार्टफोन, टैबलेट और पर्सनल कंप्यूटर के बीच एक अधिक लचीली सहयोगी कंप्यूटिंग प्रणाली बन सकती है, जिससे बड़े कृत्रिम बुद्धिमत्ता मॉडल को चलाने के लिए एकल डिवाइस हार्डवेयर कॉन्फ़िगरेशन पर निर्भरता कम हो जाएगी।
टिप्पणियाँ