सार:
जनरेटिव आर्टिफिशियल इंटेलिजेंस प्रशिक्षण डेटा की वैधता को लेकर विवाद हाल ही में फिर से गरमा गया है। न्यूयॉर्क टाइम्स कॉपीराइट मुकदमे में खोले गए एक अदालती दस्तावेज़ से पता चलता है कि माइक्रोसॉफ्ट के एक वरिष्ठ अनुसंधान निदेशक ने एक बार एक आंतरिक चर्चा में वर्णन किया था कि बड़े भाषा मॉडल की वर्तमान प्रशिक्षण पद्धति "मानव इतिहास में सबसे बड़ी श्रम चोरी" हो सकती है। संबंधित बयानों ने उद्योग में व्यापक ध्यान आकर्षित किया है।
इस बार उजागर हुई टिप्पणी माइक्रोसॉफ्ट में एप्लाइड साइंस के निदेशक ब्रेंट हेचट की ओर से आई है। नवीनतम सार्वजनिक कानूनी दस्तावेजों के अनुसार, जब माइक्रोसॉफ्ट, ओपनएआई और अन्य कृत्रिम बुद्धिमत्ता कंपनियों द्वारा मॉडलों को प्रशिक्षित करने के लिए बड़े पैमाने पर इंटरनेट सामग्री के उपयोग पर चर्चा की गई, तो हेचट ने एक बार इस प्रक्रिया को "अभूतपूर्व पैमाने की आश्चर्यजनक चोरी" कहा और आगे कहा कि यह "मानव इतिहास में सबसे बड़ी श्रम चोरी" हो सकती है।
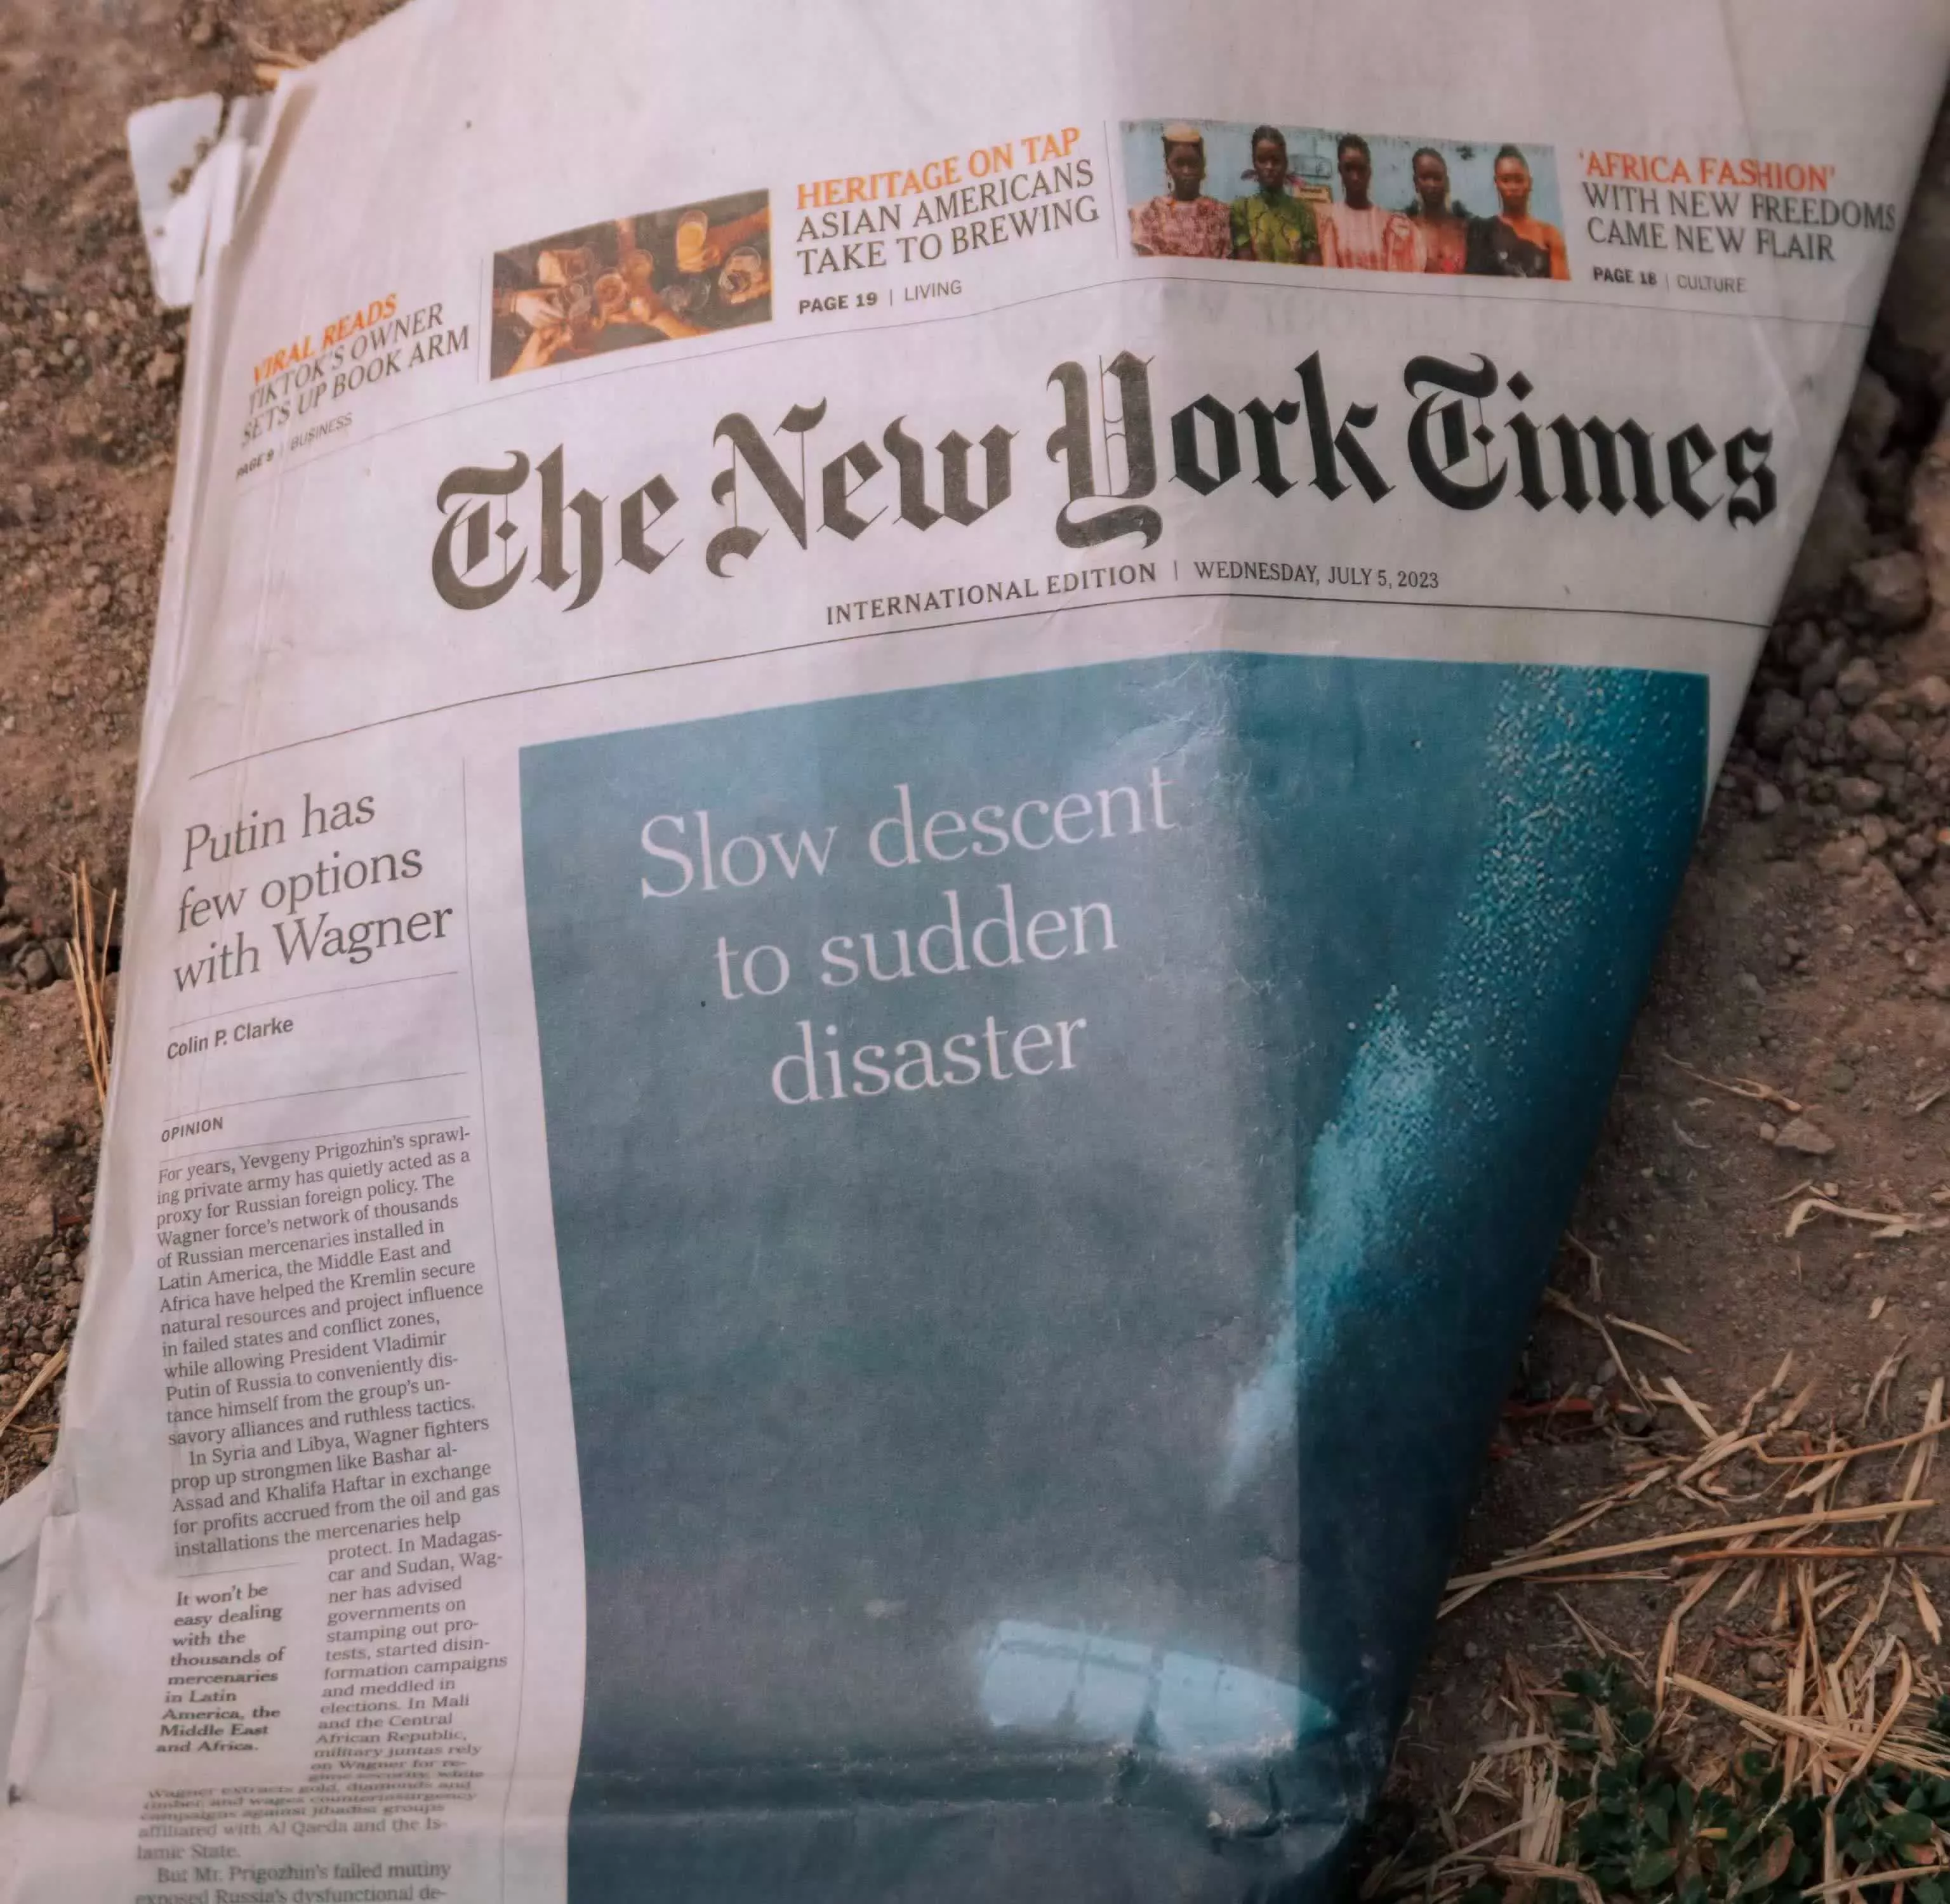
यह सामग्री न्यूयॉर्क टाइम्स और अन्य समाचार प्रकाशनों द्वारा Microsoft और OpenAI के खिलाफ दायर कॉपीराइट मुकदमे में दिखाई देती है। वादी का मानना है कि दोनों कंपनियों ने बिना प्राधिकरण के कृत्रिम बुद्धिमत्ता मॉडल को प्रशिक्षित करने और वाणिज्यिक उत्पादों को विकसित करने के लिए समाचार रिपोर्टों और अन्य कॉपीराइट सामग्री का उपयोग किया।
Microsoft और OpenAI ने हमेशा अपने "उचित उपयोग" रुख का पालन किया है। दोनों कंपनियों का मानना है कि मॉडल प्रशिक्षण प्रक्रिया ज्ञान सीखने के लिए किताबें पढ़ने वाले छात्रों के समान है और उचित उपयोग के दायरे में आती है। उनका यह भी तर्क है कि एआई-जनित सामग्री ने मूल सामग्री को पर्याप्त रूप से बदल दिया है ताकि प्रत्यक्ष नकल न हो।
हालाँकि, नए सीलबंद दस्तावेज़ों में कुछ आंतरिक संचार रिकॉर्ड इस सार्वजनिक स्थिति के स्पष्ट विपरीत प्रतीत होते हैं।
दस्तावेज़ों से पता चलता है कि हेचट का एक बार मानना था कि यदि उन्हें मुकदमा जीतना है, तो इसमें शामिल कंपनियों को "उचित उपयोग की अवधारणा का पूरी तरह से मजाक बनाना होगा।" इस कथन को वादी द्वारा महत्वपूर्ण साक्ष्य माना जाता है और इसका उपयोग कॉपीराइट रक्षा तर्क पर सवाल उठाने के लिए किया जाता है जिसका कृत्रिम बुद्धिमत्ता कंपनियां लंबे समय से पालन करती आ रही हैं।
साथ ही, दस्तावेज़ ने OpenAI की ओर से कुछ आंतरिक चर्चाओं का भी खुलासा किया। एक रिकॉर्ड से पता चलता है कि ओपनएआई के सह-संस्थापक ग्रेग ब्रॉकमैन ने स्वीकार किया कि जब मॉडल न्यूयॉर्क टाइम्स की सामग्री के संपर्क में आया, तो चैटजीपीटी वास्तव में संबंधित लेखों में वाक्यों की भविष्यवाणी करने और जारी रखने में सक्षम था। इस प्रकार की सामग्री का उपयोग वादी द्वारा यह साबित करने के लिए किया जाता है कि मॉडल में सीखी गई जानकारी को अमूर्त करने के बजाय मूल कार्य को पुन: पेश करने की क्षमता है।
मुकदमे के दस्तावेजों से यह भी पता चला कि कृत्रिम बुद्धिमत्ता उद्योग के दीर्घकालिक विकास के बारे में हेचट की चिंताएँ कॉपीराइट मुद्दे तक ही सीमित नहीं हैं। उन्होंने एक बार एक अन्य आंतरिक प्रस्तुति दस्तावेज़ में तथाकथित "डूम्सडे लूप" अवधारणा का प्रस्ताव रखा था।
इस तर्क के बाद, कृत्रिम बुद्धिमत्ता उत्तर इंजन धीरे-धीरे उपयोगकर्ताओं की समाचार वेबसाइटों पर जाने की आवश्यकता को कम कर रहे हैं, जिसके परिणामस्वरूप मीडिया ट्रैफ़िक और व्यावसायिक राजस्व में गिरावट आ रही है। जैसे-जैसे अधिक से अधिक सामग्री उत्पादन संगठन अपनी व्यवहार्यता खो रहे हैं, भविष्य में कृत्रिम बुद्धिमत्ता प्रणालियों के लिए सीखने के लिए उच्च गुणवत्ता वाली जानकारी के स्रोत भी कम हो जाएंगे, जो अंततः मॉडल और संपूर्ण इंटरनेट पारिस्थितिकी तंत्र को नुकसान पहुंचाएगा।
उन्होंने आंतरिक दस्तावेजों में बताया कि किसी उत्पाद के लिए उसके प्रमुख आपूर्तिकर्ताओं की आर्थिक नींव को खतरा होना बेहद दुर्लभ है, लेकिन कृत्रिम बुद्धिमत्ता उद्योग वर्तमान में इस स्थिति में है। चूंकि समाचार संगठन और सामग्री निर्माता एआई मॉडल के लिए जानकारी के महत्वपूर्ण स्रोत हैं, जब ये समूह प्रभावित होते हैं, तो संपूर्ण सामग्री आपूर्ति श्रृंखला खतरे में पड़ जाती है।
वादी ने माइक्रोसॉफ्ट के आंतरिक डेटा का भी हवाला दिया और दावा किया कि कोपायलट जैसे एआई उत्तर देने वाले सिस्टम ने कुछ समाचार वेबसाइटों के ट्रैफ़िक पर महत्वपूर्ण प्रभाव डाला है। कुछ मामलों में, न्यूयॉर्क टाइम्स पेज में प्रवेश करने के लिए क्लिक करने वाले उपयोगकर्ताओं का अनुपात पारंपरिक खोज परिणामों की तुलना में 90% से अधिक गिर गया।
वास्तव में, प्रशिक्षण डेटा के स्रोत पर विवाद वर्तमान कृत्रिम बुद्धिमत्ता उद्योग में सबसे महत्वपूर्ण कानूनी चुनौतियों में से एक बन गया है।
ओपनएआई ने पहले सार्वजनिक रूप से कहा है कि कॉपीराइट सामग्री के संपर्क के बिना उन्नत कृत्रिम बुद्धिमत्ता प्रणालियों को प्रशिक्षित करना लगभग असंभव कार्य है। पूर्व मेटा कार्यकारी निक क्लेग ने भी इसी तरह का बयान दिया, उनका मानना है कि यदि पारंपरिक कॉपीराइट नियमों का सख्ती से पालन किया जाता है, तो कई मौजूदा एआई सिस्टम के विकास को बनाए रखना मुश्किल होगा।
उसी समय, माइक्रोसॉफ्ट, मेटा और अन्य प्रौद्योगिकी कंपनियों सहित कई कंपनियों को प्रशिक्षण डेटा के स्रोत के मुद्दों के कारण बाहरी दुनिया से आलोचना का सामना करना पड़ रहा है। कुछ कंपनियों पर मॉडलों को प्रशिक्षित करने के लिए उपयोगकर्ता सामग्री, कोड लाइब्रेरी, लेख, चित्र और अन्य ऑनलाइन संसाधनों का उपयोग करने का आरोप लगाया गया है, अक्सर संबंधित रचनाकारों से स्पष्ट प्राधिकरण या मुआवजे के बिना।
जैसा कि न्यूयॉर्क टाइम्स का मुकदमा जारी है, अधिक से अधिक आंतरिक दस्तावेज़ सार्वजनिक किए जा रहे हैं। उद्योग के अंदरूनी सूत्रों का मानना है कि ये सामग्रियां न केवल माइक्रोसॉफ्ट और ओपनएआई द्वारा सामना किए गए कॉपीराइट मुकदमे के परिणाम से संबंधित हैं, बल्कि कृत्रिम बुद्धिमत्ता प्रशिक्षण, बौद्धिक संपदा संरक्षण और सामग्री उत्पादकों के अधिकारों और हितों के वितरण पर भविष्य की वैश्विक नियामक दिशा को भी प्रभावित कर सकती हैं।
वर्तमान में, प्रासंगिक मामले अभी भी समीक्षाधीन हैं। अंतिम फैसले के बावजूद, कृत्रिम बुद्धिमत्ता प्रशिक्षण की वैधता से जुड़ा यह कानूनी विवाद एआई उद्योग के भविष्य के विकास नियमों को निर्धारित करने में एक महत्वपूर्ण मील का पत्थर बन रहा है।
टिप्पणियाँ