सार:
NVIDIA ने अगली पीढ़ी के वेरा रुबिन कृत्रिम बुद्धिमत्ता कंप्यूटिंग प्लेटफ़ॉर्म के कुछ हार्डवेयर विनिर्देशों को समायोजित किया है, जिसमें HBM4 हाई-बैंडविड्थ मेमोरी बैंडविड्थ और NVLink हाई-स्पीड इंटरकनेक्ट बैंडविड्थ शामिल हैं। पहले घोषित या प्रसारित संकेतकों की तुलना में, नए विनिर्देशों में गिरावट आई है, लेकिन क्षैतिज विस्तार नेटवर्क बैंडविड्थ में वृद्धि हुई है। इस बदलाव का मतलब यह हो सकता है कि एनवीडिया वास्तविक बड़े पैमाने पर उत्पादन के आधार पर चिप प्रदर्शन, आपूर्ति क्षमताओं और सिस्टम लागत को पुनर्संतुलित कर रहा है।
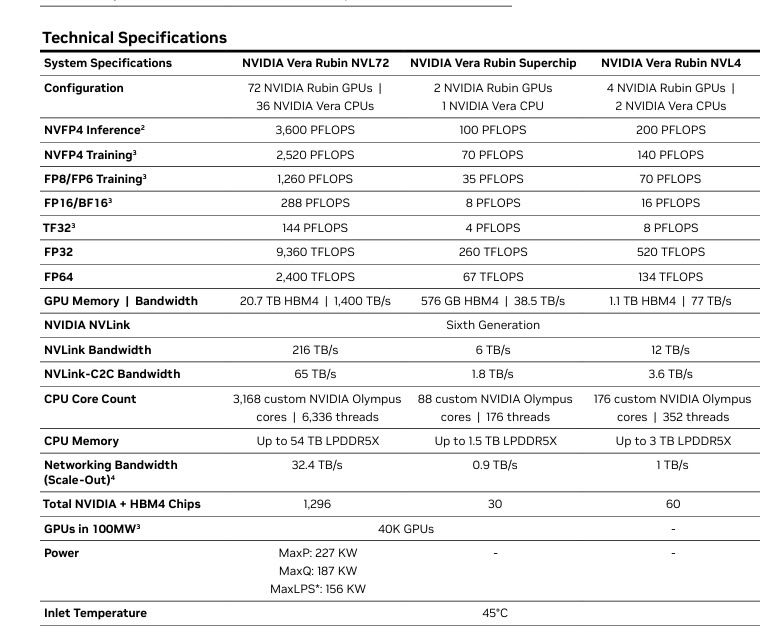
वर्तमान में NVIDIA द्वारा घोषित वेरा रुबिन प्लेटफ़ॉर्म विनिर्देशों के अनुसार, रुबिन GPU 288GB HBM4 मेमोरी और 19.2TB/s की मेमोरी बैंडविड्थ से लैस है। पहले, NVIDIA के तकनीकी डेटा ने 22TB/s का अधिकतम मेमोरी बैंडविड्थ संकेतक दिया था। दोनों की तुलना में, वर्तमान में घोषित मूल्य लगभग 12.7% कम है। यह ध्यान रखना महत्वपूर्ण है कि एनवीडिया ने पहले "अधिकतम प्राप्य" मीट्रिक का उपयोग किया था, इसलिए यह विशिष्ट संख्याओं में परिवर्तन को दर्शाता है और इसका मतलब यह नहीं है कि सभी उत्पादों ने वास्तविक प्रदर्शन में समान गिरावट का अनुभव किया है।
HBM4 उच्च-बैंडविड्थ मेमोरी तकनीक की एक नई पीढ़ी है जो कृत्रिम बुद्धिमत्ता मॉडल प्रशिक्षण और अनुमान के लिए उच्च डेटा थ्रूपुट क्षमताएं प्रदान करने के लिए व्यापक मेमोरी इंटरफ़ेस का उपयोग करती है। जैसे-जैसे मॉडल का आकार बढ़ता जा रहा है, GPU को न केवल मजबूत कंप्यूटिंग शक्ति की आवश्यकता होती है, बल्कि बड़ी मात्रा में मॉडल पैरामीटर और मध्यवर्ती डेटा भी लगातार प्राप्त करना पड़ता है। यदि मेमोरी बैंडविड्थ अपर्याप्त है, भले ही कंप्यूटिंग यूनिट में उच्च सैद्धांतिक कंप्यूटिंग शक्ति हो, यह डेटा की प्रतीक्षा के कारण अपने प्रदर्शन को पूरी तरह से लागू करने में सक्षम नहीं हो सकता है।
रुबिन प्लेटफ़ॉर्म द्वारा पहले अपनाई गई उच्च मेमोरी बैंडविड्थ ने HBM4 आपूर्ति श्रृंखला में उच्च तकनीकी आवश्यकताएं भी ला दी हैं। वीडियो मेमोरी निर्माताओं को उच्च डेटा ट्रांसफर दरों पर बिजली की खपत, थर्मल अपव्यय, सिग्नल अखंडता और दीर्घकालिक विश्वसनीयता आवश्यकताओं को पूरा करने की आवश्यकता होती है। बैंडविड्थ विनिर्देश जितना अधिक होगा, डिज़ाइन सत्यापन और वॉल्यूम उत्पादन प्रक्रियाओं में आम तौर पर चुनौतियों का सामना करना उतना ही अधिक होगा।
यदि NVIDIA अपनी मेमोरी बैंडविड्थ आवश्यकताओं को कम करता है, तो उत्पाद मानकों को पूरा करने वाले HBM4 चिप्स की श्रृंखला का विस्तार हो सकता है, और आपूर्तिकर्ताओं के पास योग्य उत्पादों के आउटपुट अनुपात को बढ़ाने का अवसर भी होगा। इसका मतलब यह नहीं है कि वीडियो मेमोरी निर्माताओं को उत्पादों के पूरे सेट को फिर से डिज़ाइन करना होगा, लेकिन यह कुछ उत्पादों को अनुमति दे सकता है जो पिछले उच्चतम प्रदर्शन लक्ष्यों तक नहीं पहुंच सकते हैं लेकिन फिर भी आपूर्ति प्रणाली में प्रवेश करने के लिए नई आवश्यकताओं को पूरा करते हैं, जिससे समग्र आपूर्ति क्षमताओं में सुधार होता है।
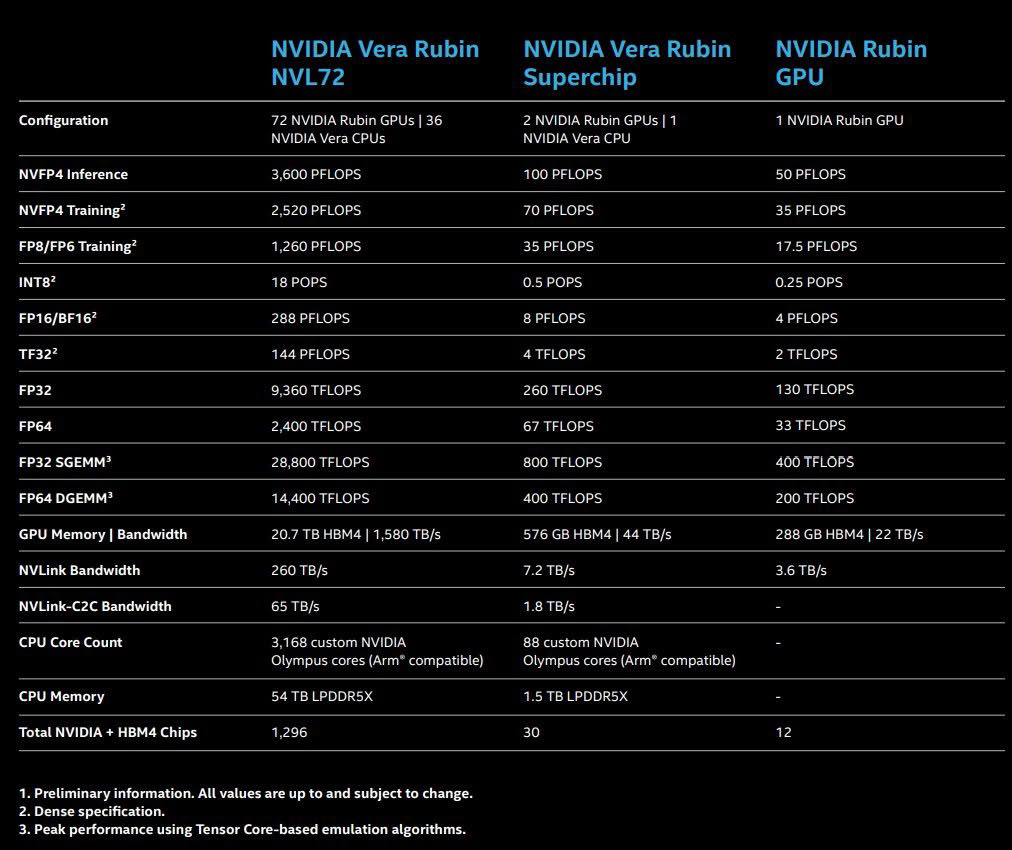
मेमोरी बैंडविड्थ के अलावा, एनवीडिया ने वेरा रुबिन सुपर चिप के एनवीलिंक इंटरकनेक्ट विनिर्देश को भी समायोजित किया है। वर्तमान उत्पाद जानकारी के अनुसार, वेरा रुबिन सुपर चिप की एनवीलिंक बैंडविड्थ को पिछले 7.2TB/s से 6TB/s तक समायोजित किया गया है, जो लगभग 16.7% की कमी है। NVLink GPU के बीच उच्च गति संचार के लिए NVIDIA की इंटरकनेक्ट तकनीक है। यह मल्टी-जीपीयू सिस्टम में डेटा एक्सचेंज, मॉडल समानांतर प्रशिक्षण और जटिल कृत्रिम बुद्धिमत्ता अनुमान कार्यों में महत्वपूर्ण भूमिका निभाता है।
बड़े कृत्रिम बुद्धिमत्ता समूहों में, ग्रेडिएंट, सक्रियण मान और अन्य मध्यवर्ती डेटा को GPU के बीच अक्सर आदान-प्रदान करने की आवश्यकता होती है। विशेषज्ञ हाइब्रिड आर्किटेक्चर वाले बड़े मॉडलों के लिए विभिन्न कंप्यूटिंग इकाइयों के बीच संचार विशेष रूप से महत्वपूर्ण है। इसलिए, एनवीलिंक बैंडविड्थ संकेतक को कम करने से कुछ संचार-गहन कार्यों का प्रदर्शन प्रभावित हो सकता है, लेकिन अंतिम प्रभाव अभी भी मॉडल आर्किटेक्चर, सॉफ्टवेयर शेड्यूलिंग विधि और वास्तविक लोड पर निर्भर करता है। समग्र कंप्यूटिंग शक्ति हानि की गणना केवल बैंडविड्थ कटौती अनुपात के आधार पर नहीं की जा सकती है।
उसी समय, एनवीडिया ने कुछ स्केल-आउट नेटवर्क के लिए बैंडविड्थ मेट्रिक्स में वृद्धि की है। मौजूदा डेटा से पता चलता है कि वेरा रुबिन सुपर चिप का क्षैतिज विस्तार नेटवर्क बैंडविड्थ पिछले 0.8TB/s से बढ़कर 0.9TB/s हो गया है। इस प्रकार के नेटवर्क का उपयोग मुख्य रूप से विभिन्न कंप्यूटिंग नोड्स को जोड़ने के लिए किया जाता है, जिससे डेटा केंद्रों को बड़ी संख्या में जीपीयू को एक एकीकृत कंप्यूटिंग क्लस्टर में व्यवस्थित करने की अनुमति मिलती है। नेटवर्क बैंडविड्थ बढ़ाने से नोड्स के बीच डेटा ट्रांसफर क्षमताओं को बेहतर बनाने में मदद मिल सकती है, खासकर जब कंप्यूटिंग कार्यों को सर्वरों में सहयोगात्मक रूप से पूरा करने की आवश्यकता होती है।
एक डाउन और एक अप का यह समायोजन कृत्रिम बुद्धिमत्ता कंप्यूटिंग प्लेटफार्मों के डिजाइन में व्यापार-बंद संबंध को दर्शाता है: जीपीयू के भीतर और कैबिनेट के भीतर संचार क्षमताएं महत्वपूर्ण हैं, लेकिन जैसे-जैसे क्लस्टर स्केल का विस्तार होता है, क्रॉस-नोड संचार भी समग्र प्रदर्शन को सीमित करने वाला एक कारक बन सकता है। एनवीडिया वास्तविक अनुप्रयोग आवश्यकताओं के आधार पर सिस्टम डिज़ाइन में प्रदर्शन बजट को पुनः आवंटित कर सकता है।
हालाँकि, विनिर्देश परिवर्तन स्वयं यह साबित नहीं करता है कि एनवीडिया ने पुष्टि की है कि वीडियो मेमोरी की कमी है, न ही यह अकेले यह साबित कर सकता है कि संकेतक को कम करने का मतलब उत्पादन बढ़ाना है। प्रासंगिक स्पष्टीकरणों को अभी भी आपूर्तिकर्ता की बड़े पैमाने पर उत्पादन प्रगति, उत्पाद प्रमाणन स्थिति और एनवीडिया द्वारा प्रकट की गई बाद की जानकारी के आधार पर आंकने की आवश्यकता है।
HBM4 आपूर्ति श्रृंखला के लिए, विनिर्देश समायोजन आपूर्तिकर्ताओं के बीच प्रतिस्पर्धा का फोकस बदल सकता है। पहले, निर्माताओं को उच्च डेटा ट्रांसमिशन गति के लिए प्रयास करने की आवश्यकता होती थी; यदि एनवीडिया बड़े पैमाने पर उत्पादन उत्पादों के लिए बैंडविड्थ आवश्यकताओं को कम कर देता है, तो प्रतिस्पर्धा उपज, आपूर्ति पैमाने, बिजली की खपत, स्थिरता और लागत पर अधिक केंद्रित हो सकती है। जो आपूर्तिकर्ता बड़े पैमाने पर योग्य उत्पाद वितरित कर सकते हैं, उन्हें परिणामस्वरूप अधिक अवसर प्राप्त हो सकते हैं।
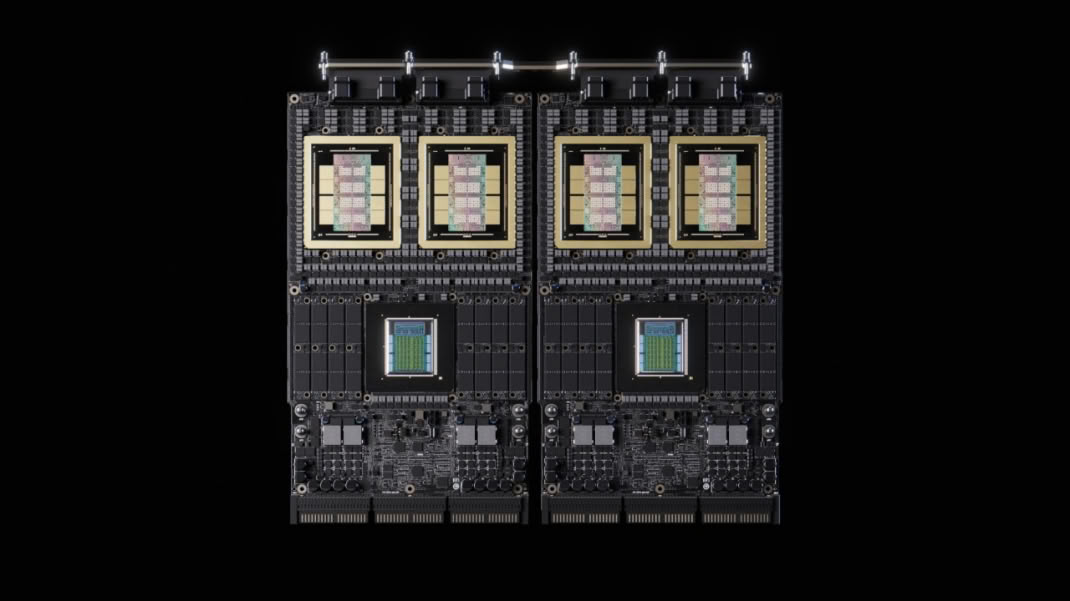
संपूर्ण प्लेटफ़ॉर्म के परिप्रेक्ष्य से, वेरा रुबिन प्रदर्शन निर्धारित करने के लिए केवल मेमोरी बैंडविड्थ पर निर्भर नहीं है। GPU कंप्यूटिंग शक्ति, वीडियो मेमोरी क्षमता, चिप-टू-चिप इंटरकनेक्शन, नेटवर्क आर्किटेक्चर और सॉफ़्टवेयर अनुकूलन संयुक्त रूप से सिस्टम प्रदर्शन निर्धारित करते हैं। एनवीडिया की आधिकारिक तौर पर घोषित वेरा रुबिन एनवीएल72 कैबिनेट कॉन्फ़िगरेशन में 72 रुबिन जीपीयू शामिल हैं और बड़े पैमाने पर कृत्रिम बुद्धिमत्ता प्रशिक्षण और अनुमान कार्यों का समर्थन करने के लिए छठी पीढ़ी के एनवीलिंक के माध्यम से कई जीपीयू को जोड़ता है।
इसलिए, भले ही कुछ हार्डवेयर संकेतक शुरुआती लक्ष्यों से कम हों, वेरा रुबिन अभी भी कंप्यूटिंग आर्किटेक्चर, वीडियो मेमोरी क्षमता और सिस्टम-स्तरीय अनुकूलन के माध्यम से उच्च प्रदर्शन प्राप्त कर सकता है। वास्तव में ध्यान देने योग्य बात यह है कि क्या एनवीडिया विनिर्देशों को समायोजित करने के बाद योजना के अनुसार शिपमेंट का विस्तार कर सकता है, और क्या वास्तविक मॉडल प्रशिक्षण और अनुमान प्रदर्शन ग्राहकों की अपेक्षाओं को पूरा करता है।
टिप्पणियाँ