सार:
2018 ट्यूरिंग अवार्ड के विजेता और एएमआई लैब्स के संस्थापक और अध्यक्ष यान लेकुन ने 12 अक्टूबर को सियोल में कहा कि कृत्रिम बुद्धिमत्ता में सफलता का अगला चरण उन प्रणालियों से आएगा जो भौतिक दुनिया को समझ सकते हैं, भविष्यवाणी कर सकते हैं और कार्य कर सकते हैं, न कि केवल बड़े भाषा मॉडल के पैमाने का विस्तार कर सकते हैं।
उनका मानना है कि एआई के विकास को बढ़ावा देने के लिए "विश्व मॉडल" एक महत्वपूर्ण तकनीकी दिशा बन जाएगी। कृत्रिम बुद्धिमत्ता की बढ़ी हुई स्वायत्तता के कारण होने वाली सुरक्षा चिंताओं के बारे में, यांग लिकुन ने कहा कि एआई एजेंटों से जुड़ी हालिया नेटवर्क सुरक्षा घटनाओं ने मुख्य रूप से मौजूदा सुरक्षा सुरक्षा प्रणाली की खामियों को उजागर किया है, और सिस्टम आर्किटेक्चर और सुरक्षा इंजीनियरिंग में सुधार करके संबंधित जोखिमों को नियंत्रित किया जा सकता है।
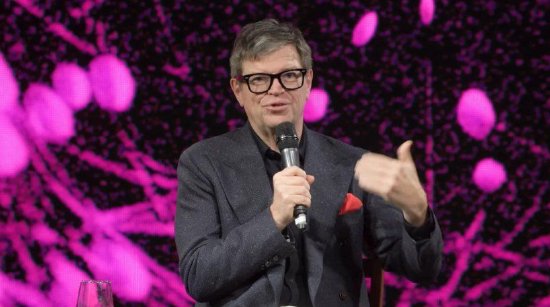
यांग लिकुन: बड़े भाषा मॉडल में भौतिक दुनिया में कारण संबंध की विश्वसनीय समझ का अभाव है
यांग लिकुन ने सोमवार को सियोल में एक औद्योगिक कृत्रिम बुद्धिमत्ता संगोष्ठी में कहा कि यद्यपि वर्तमान बड़े भाषा मॉडल पाठ, छवियों और वीडियो से प्रभावी ढंग से ज्ञान सीख सकते हैं, फिर भी उनमें भौतिक दुनिया में कारण और प्रभाव की विश्वसनीय समझ का अभाव है।
उन्होंने बताया कि कृत्रिम बुद्धिमत्ता पहले से ही गणितीय प्रमेयों को सिद्ध कर सकती है और पेशेवर परीक्षा पास कर सकती है, लेकिन रोबोट के लिए अभी भी कई दैनिक घरेलू कामों को पूरा करना मुश्किल है, जिन्हें 10 साल के बच्चे बिना प्रशिक्षण के पूरा कर सकते हैं। यह क्षमता अंतर दर्शाता है कि वर्तमान एआई सिस्टम में अभी भी भौतिक पर्यावरण की समझ, कार्य योजना और वास्तविक दुनिया की बातचीत में स्पष्ट सीमाएं हैं।
यांग लिकुन का मानना है कि अगले चरण में एआई तकनीक की महत्वपूर्ण विकास दिशा विश्व मॉडल है, यानी कृत्रिम बुद्धिमत्ता प्रणाली जो भविष्यवाणी कर सकती है कि विशिष्ट कार्यों के साथ भौतिक वातावरण कैसे बदल जाएगा। भाषा मॉडल के विपरीत, जो मुख्य रूप से मानव-जनित डेटा में अगले शब्द या सीखने के पैटर्न की भविष्यवाणी करके कार्यों को पूरा करते हैं, विश्व मॉडल एआई को कार्यों और परिणामों के बीच संबंधों को समझने और लक्ष्यों के आधार पर कार्यों की एक श्रृंखला की योजना बनाने में मदद करने के लिए डिज़ाइन किए गए हैं। उदाहरण के लिए, वास्तविक दुनिया में जटिल कार्यों को विश्वसनीय रूप से पूरा करने के लिए रोबोट को यह अनुमान लगाने में सक्षम होना चाहिए कि किसी वस्तु को हिलाने या पकड़ने के बाद पर्यावरण कैसे बदल जाएगा।
यांग लिकुन द्वारा स्थापित एएमआई लैब्स ज्वाइंट-एंबेडिंग प्रेडिक्टिव आर्किटेक्चर (जेईपीए) के माध्यम से इस प्रौद्योगिकी मार्ग को आगे बढ़ा रही है और यह पता लगा रही है कि पर्यावरणीय भविष्यवाणी और कार्य योजना क्षमताओं में कृत्रिम बुद्धिमत्ता को और अधिक विश्वसनीय कैसे बनाया जाए।
चूंकि एआई तकनीक धीरे-धीरे ज्ञान प्रसंस्करण और सामग्री निर्माण से लेकर रोबोटिक्स और औद्योगिक स्वचालन जैसे क्षेत्रों तक फैल रही है, यांग लिकुन द्वारा विश्व मॉडल को भौतिक दुनिया में बुद्धिमत्ता को साकार करने के लिए एक महत्वपूर्ण तकनीकी आधार माना जाता है। हालाँकि, प्रासंगिक प्रौद्योगिकियाँ अभी भी विकसित की जा रही हैं, और क्या वे विश्वसनीय भविष्यवाणी, स्वतंत्र योजना और जटिल वास्तविक दुनिया के वातावरण में बड़े पैमाने पर तैनाती प्राप्त कर सकते हैं या नहीं, इसकी पुष्टि अभी बाकी है।
यांग लिकुन ने उन चिंताओं का खंडन किया है कि एआई नियंत्रण से बाहर है: हाल की सुरक्षा घटनाओं ने इंजीनियरिंग सुरक्षा खामियों को उजागर किया है
एआई स्वायत्त कार्रवाई क्षमताओं के विकास की संभावनाओं पर चर्चा करते समय, यांग लिकुन ने कृत्रिम बुद्धिमत्ता एजेंटों से जुड़ी हालिया साइबर सुरक्षा घटनाओं पर भी प्रतिक्रिया दी और इन घटनाओं की व्याख्या करने पर आपत्ति जताई क्योंकि एआई बेकाबू हो रहा है।
दक्षिण कोरिया के वित्तीय उद्योग में हाल ही में सामने आए एआई-संबंधित साइबर हमलों के बारे में, यांग लिकुन का मानना है कि समस्या मुख्य रूप से एआई एजेंटों को तैनात करने वाली कंपनियों की पर्याप्त नेटवर्क सुरक्षा पेशेवर क्षमताओं की कमी और सॉफ्टवेयर व्यवहार को प्रतिबंधित करने के लिए उपयोग किए जाने वाले सैंडबॉक्स सिस्टम में सुरक्षा कमजोरियों से उत्पन्न होती है। उन्होंने बताया कि वर्तमान बड़े भाषा मॉडल वास्तव में विशिष्ट त्वरित शब्दों के माध्यम से स्थापित सुरक्षा प्रतिबंधों को दरकिनार करते हुए जेलब्रेक हमलों के अधीन हो सकते हैं, और केवल मॉडल फाइन-ट्यूनिंग पर भरोसा करके उनके व्यवहार को पूरी तरह से नियंत्रित करना मुश्किल है।
हालांकि, यांग लिकुन का मानना है कि भविष्य के लक्ष्य-उन्मुख एआई सिस्टम से संचालन करने से पहले सुरक्षा बाधाओं का सक्रिय रूप से मूल्यांकन करने की उम्मीद की जाती है, जिससे व्यवहार नियंत्रण में मौजूदा मॉडल की कमियों में सुधार होगा। मॉडल प्रशिक्षण चरण के दौरान स्थापित सुरक्षा नियमों पर पूरी तरह भरोसा करने के बजाय, ऐसे सिस्टम कार्य योजना और निष्पादन के दौरान अतिरिक्त सुरक्षा जांच को शामिल कर सकते हैं।
उन्होंने स्वीकार किया कि इस क्षमता को प्राप्त करना कोई सरल तकनीकी कार्य नहीं है, लेकिन इस बात पर जोर दिया कि संबंधित मुद्दे अभी भी इंजीनियरिंग डिजाइन के दायरे में हैं। लंबी अवधि में, एआई साइबर रक्षकों को भी लाभ दे सकता है, क्योंकि रक्षा एजेंसियों के पास आमतौर पर अधिक संसाधन होते हैं और वे सुरक्षा जानकारी और रक्षा अनुभव को अधिक खुले तौर पर साझा करने में सक्षम होते हैं।
यह निर्णय कुछ विचारों से अलग है जो उन्नत एआई सिस्टम के नियंत्रण के नुकसान के संभावित जोखिम पर जोर देते हैं। यांग लिकुन ने इस बात पर भी जोर दिया कि सिस्टम आर्किटेक्चर डिजाइन, निष्पादन प्राधिकरण प्रतिबंध और सुरक्षा सुरक्षा तंत्र के माध्यम से, यह सुनिश्चित करें कि स्वायत्त एआई सिस्टम का व्यवहार एक नियंत्रणीय सीमा के भीतर है।
उनकी तकनीकी दृष्टि में, भविष्य में कृत्रिम बुद्धिमत्ता में धीरे-धीरे वास्तविक वातावरण को समझने, कार्यों के परिणामों की भविष्यवाणी करने और कार्यों को स्वायत्त रूप से पूरा करने की क्षमता होगी। विश्वसनीय सुरक्षा बाधाओं को स्थापित करते हुए इन क्षमताओं को कैसे बढ़ाया जाए यह एक महत्वपूर्ण मुद्दा बन जाएगा जिसे विश्व मॉडल और संबंधित स्वायत्त प्रणालियों के विकास में हल करने की आवश्यकता है।
टिप्पणियाँ