सार:
मार्च 2016, फोर सीजन्स होटल सियोल। मानव-मशीन युद्ध के दूसरे गेम के मध्य में, अल्फ़ागो ने पांचवीं पंक्ति पर एक सनस्पॉट गिरा दिया। साइट पर कमेंट्री के लिए शब्द नहीं बचे थे और कुछ लोगों को संदेह था कि कार्यक्रम में कोई बग था, क्योंकि पेशेवर शतरंज खिलाड़ियों की सामान्य समझ के अनुसार, यह कदम लगभग एक फ्री थ्रो था।
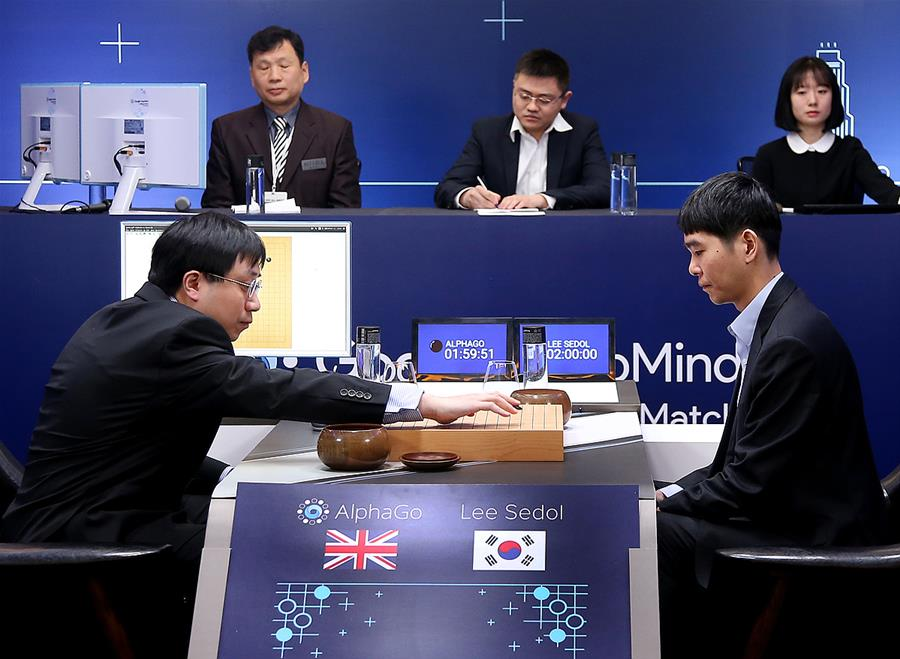
आगे की कहानी हर कोई जानता है. अल्फ़ागो ने न केवल वह गेम जीता, बल्कि ली सेडॉल को 4:1 के कुल स्कोर से हराया। खेल के बाद, ली सेडॉल ने कुछ ऐसा कहा जिसे अक्सर उद्धृत किया जाता है: "मैंने मूल रूप से सोचा था कि अल्फ़ागो सिर्फ संभाव्यता गणना पर आधारित एक मशीन थी। लेकिन उस हाथ को देखने के बाद, मैंने अपना विचार बदल दिया। अल्फ़ागो को रचनात्मक होना चाहिए।"
यह प्रसिद्ध चाल 37 है।
दस साल बाद, अल्फ़ागो बनाने वाले व्यक्ति ने खड़े होकर कहा: आज के एआई में वे क्षमताएं नहीं हैं जिन पर शतरंज का खेल निर्भर करता है।
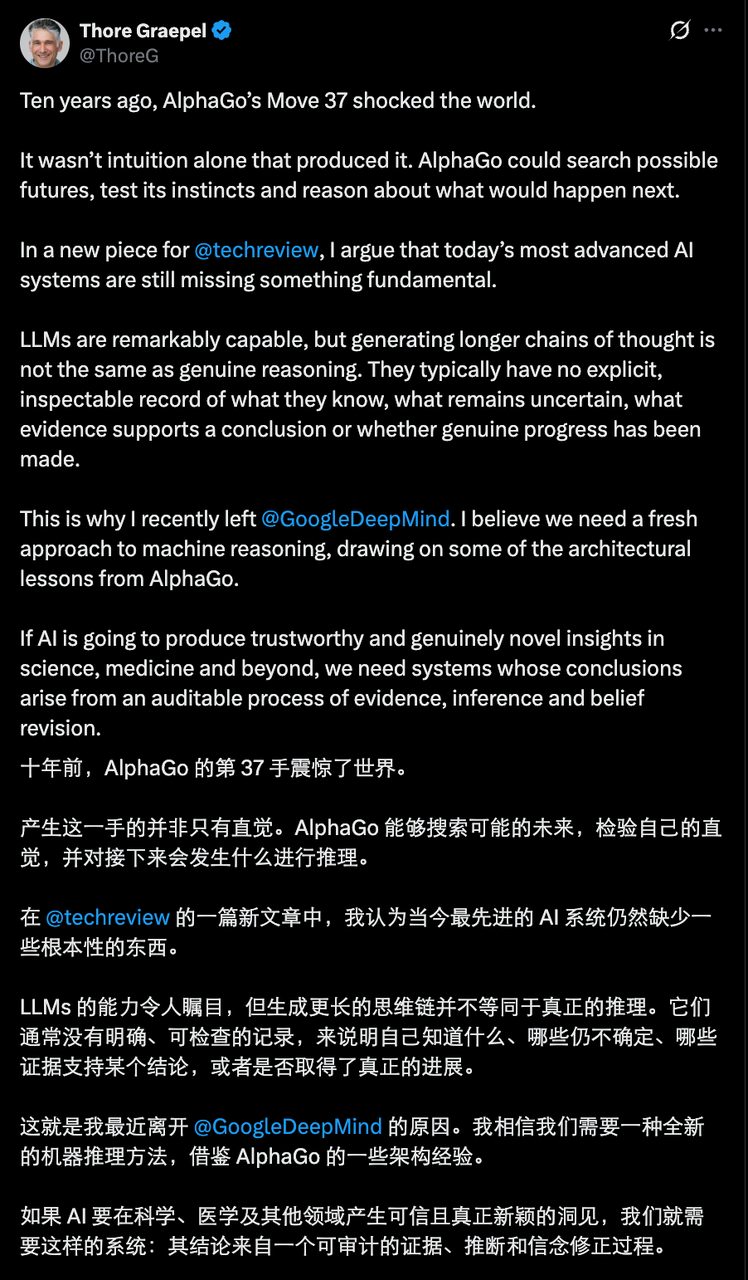
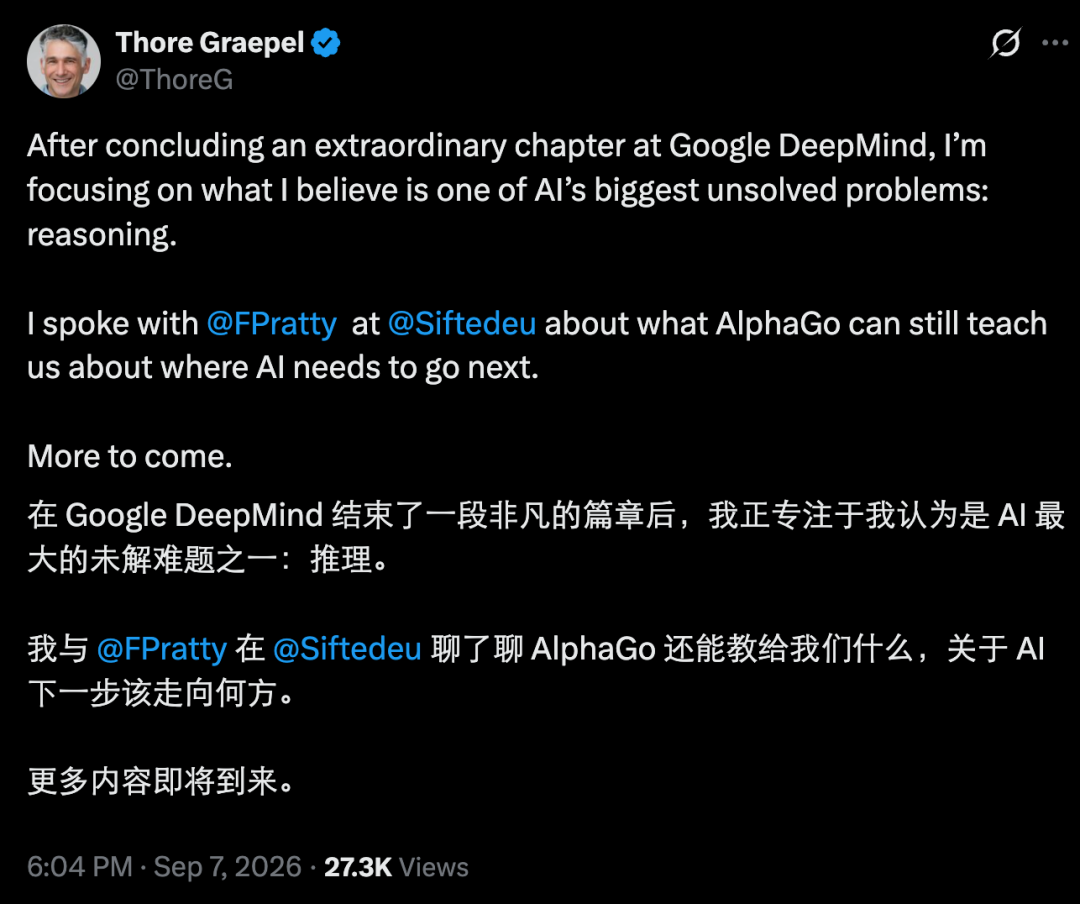
जिस व्यक्ति ने यह कहा है वह थोर ग्रेपेल हैं, जो अल्फ़ागो के मुख्य लेखकों में से एक हैं और लंबे समय से मशीन लर्निंग अनुसंधान में लगे हुए हैं। हाल ही में, उन्होंने एक दिलचस्प निर्णय लिया - Google डीपमाइंड को छोड़कर कुछ ऐसा करने के लिए व्यवसाय शुरू करना जो उन्हें लगता है कि अधिक महत्वपूर्ण है: मशीनों को वास्तविक तर्क क्षमताओं से लैस करना।
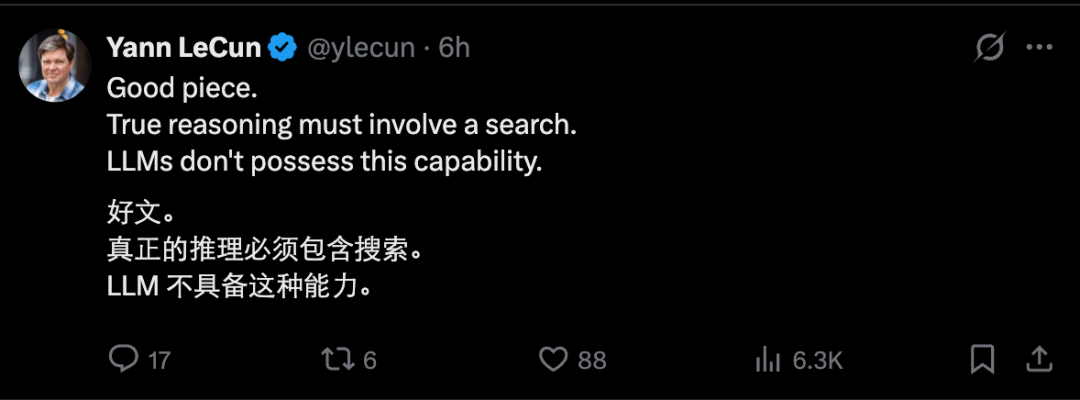
वह मार्मिक बात उनके द्वारा हाल ही में एमआईटी टेक्नोलॉजी रिव्यू में प्रकाशित एक लेख से आती है। लेख का शीर्षक बहुत सीधा है, जिसका नाम है "मूर्ख मत बनो - एलएलएम तर्क नहीं कर सकते।" इस लेख को पढ़ने के बाद, ट्यूरिंग पुरस्कार विजेता यान लेकुन ने अपनी प्रशंसा व्यक्त की और इस बात पर जोर दिया कि "वास्तविक तर्क में खोज शामिल होनी चाहिए, और एलएलएम में यह क्षमता नहीं है।"
थोर ग्रेपेल ने ऐसा क्यों कहा? आइए एक नजर डालते हैं कि इस आर्टिकल में क्या लिखा है.
मूव 37 कोई "प्रेरणा की चमक" नहीं थी,
यह तर्क का उत्पाद है
कई लोग 37वीं चाल को "मशीन अंतर्ज्ञान का पौराणिक क्षण" के रूप में वर्णित करते हैं - बिजली की एक चमक में, एआई ने मानव शतरंज के हजार साल के इतिहास से परे एक उत्कृष्ट चाल देखी। ग्रेपेल ने कहा कि अल्फ़ागो के बारे में यह सबसे बड़ी ग़लतफ़हमी है।
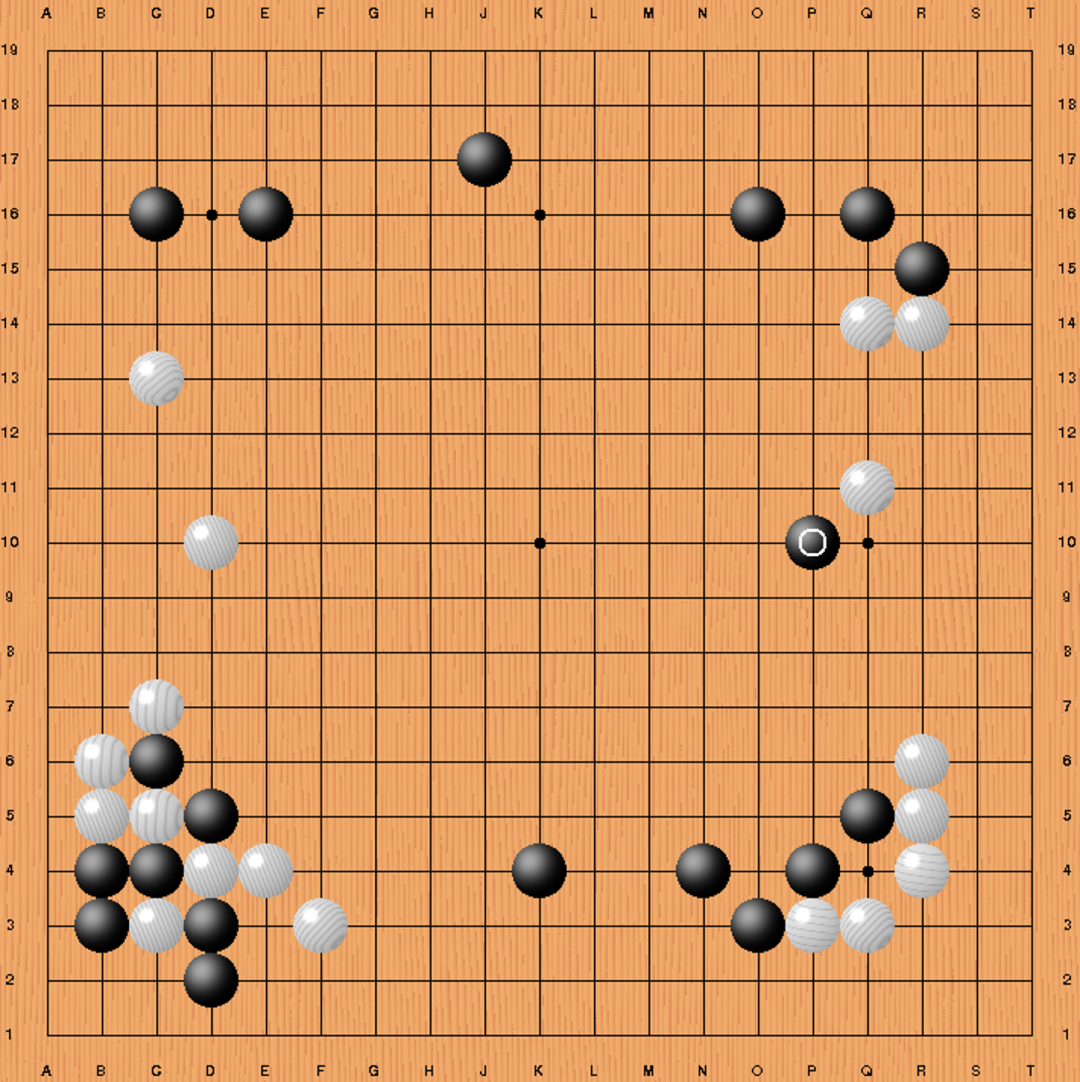
इसे समझने के लिए, हमें पहले अल्फ़ागो की आंतरिक संरचना को नष्ट करना होगा। इसमें दो प्रणालियाँ शामिल हैं: एक नीति नेटवर्क है, जो बड़े पैमाने पर मानव शतरंज रिकॉर्ड से सीखकर भविष्यवाणी करता है कि "मास्टर इस स्थिति में कैसे खेलेंगे।" यह सहज ज्ञान युक्त भाग है. दूसरा एक खोज तंत्र है, जो इस बात की परवाह नहीं करता है कि एक निश्चित शतरंज चाल "ऐसा लगता है जैसे यह एक मानव द्वारा खेला गया था", लेकिन स्पष्ट रूप से एक गेम ट्री बनाता है जिसमें हजारों शाखाएं होती हैं ताकि प्रत्येक उम्मीदवार की स्थिति के भविष्य का अनुमान लगाया जा सके।
मुख्य बिंदु यह है: रणनीति नेटवर्क की नजर में, चाल 37 उल्लेखनीय नहीं है - एक पेशेवर मानव शतरंज खिलाड़ी द्वारा इस चाल को खेलने की संभावना 10,000 में केवल 1 है। यदि आप केवल अपने अंतर्ज्ञान की सुनते हैं, तो यह हाथ बिल्कुल भी नहीं चुना जाएगा। यह खोज तंत्र ही था जिसने सावधानीपूर्वक गणना के बाद पाया कि इस "अविश्वसनीय" कदम का बेहतर अंत हुआ।
ग्रेपेल ने इसे समझाने के लिए कन्नमैन की प्रसिद्ध रूपरेखा का उपयोग किया है। मानव सोच को दो तरीकों में विभाजित किया गया है: सिस्टम 1 तेज़, सहज और सहज है; सिस्टम 2 धीमा है, चरण-दर-चरण है, और सावधानीपूर्वक तौला गया है। अल्फ़ागो मशीन पर इन दो मोडों का एक दुर्लभ संयोजन होता है: तंत्रिका नेटवर्क "इस कदम के लिए एक मौका है" और "इस स्थिति को जीता जाना है" का अंतर्ज्ञान प्रदान करता है, और खोज तंत्र भविष्य में आक्रामक और रक्षात्मक परिवर्तनों में इन अंतर्ज्ञानों का परीक्षण करने के लिए जिम्मेदार है। यह बिना किसी आधे के काम नहीं करेगा: अकेले अंतर्ज्ञान कभी भी 37वीं चाल नहीं चलेगा; अकेले हिंसक खोज गो की खगोलीय संभावनाओं को उजागर करने में सक्षम नहीं होगी।
यहां एक और तुलना है जिसे अक्सर नजरअंदाज कर दिया जाता है। डीप ब्लू ने प्रति सेकंड 200 मिलियन शतरंज स्थितियों का मूल्यांकन करने और छह से आठ कदम आगे देखने के लिए मनुष्यों द्वारा हार्ड-कोड किए गए नियमों पर भरोसा करके 1997 में कास्पारोव को हराया। गो की जटिलता पूरी तरह से दूसरे स्तर पर है। एक टुकड़े का मूल्य दर्जनों राउंड के बाद गति और क्षेत्र की वृद्धि और गिरावट पर निर्भर करता है। भले ही सभी परिवर्तनों के केवल एक छोटे से हिस्से की गणना की जाए, एक सुपर कंप्यूटर को अरबों वर्षों में इसकी गणना करनी होगी। इसलिए, अल्फ़ागो को "स्थिति को एक नज़र में स्पष्ट रूप से देखना" सीखना चाहिए और यहां तक कि ऐसी चालें भी बनानी चाहिए जिनके बारे में इंसानों ने कभी नहीं सोचा हो। इसे कंप्यूटिंग शक्ति को कुचलकर नहीं जीता जा सकता, जो महत्वपूर्ण है।
बड़ा भाषा मॉडल:
एक प्रणाली को चरम 1
तक प्रशिक्षित किया गयाआइए आज के AI पर नजर डालते हैं।
बड़े भाषा मॉडल का कार्य सिद्धांत अगले टोकन की बार-बार भविष्यवाणी करना है। यह अनिवार्य रूप से क्रिया में सिस्टम 1 है: तेज़, सहयोगी, और लगभग हर उस क्षेत्र में आश्चर्यजनक पैटर्न पूरा करने में सक्षम जिसके बारे में मनुष्यों ने कभी लिखा है, लेकिन "उत्तर देने से पहले सोचें" भाग के बिना।
चैटजीपीटी के जन्म के कुछ ही समय बाद, उद्योग को एहसास हुआ कि अकेले भाषा प्रवाह वास्तविक उपयोगिता का समर्थन नहीं कर सकता है। हर कोई उपाय योजना से परिचित है: मॉडल को उत्तर देने में जल्दबाजी न करने दें, पहले मध्यवर्ती चरण उत्पन्न करें, समस्या को अलग करें, और मध्यवर्ती परिणामों को साथ लाएं - यानी विचार की श्रृंखला।
सोच श्रृंखला में सुधार वास्तविक है, खासकर गणित और कोडिंग में। लेकिन ग्रेपेल ने एक तथ्य की ओर इशारा किया जो उत्तेजना से आसानी से अस्पष्ट हो जाता है: ये मध्यवर्ती तर्क चरण अभी भी "अगले टोकन की भविष्यवाणी" की एक ही प्रक्रिया हैं, यह अंतिम उत्तर देने से पहले बस थोड़ा और समय दोहराता है। यह अल्फ़ागो की खोज की तरह वास्तव में स्वतंत्र तर्क तंत्र का परिचय नहीं देता है। अंतर्ज्ञान खिंचता है, परंतु विवेक में नहीं बदलता।
उन्होंने यह समझाने के लिए तीन कमियों को सूचीबद्ध किया कि चैटबॉट जो करता है वह "वैज्ञानिकों द्वारा मान्यता प्राप्त तर्क" से कम क्यों है।
सबसे पहले, मॉडल में स्पष्ट, लगातार अद्यतन और निरीक्षण योग्य संज्ञानात्मक स्थिति नहीं है। इस समय यह किन परिकल्पनाओं पर विचार कर रहा है, यह विभिन्न स्पष्टीकरणों में कितना विश्वास रखता है, यह किन साक्ष्यों का वजन कर रहा है, और कौन से प्रश्न अनुत्तरित हैं। नई जानकारी आने पर इन चीजों को व्यवस्थित रूप से संशोधित किया जाना चाहिए, लेकिन मॉडल के भीतर ऐसा कोई "खुला खाता" नहीं है।
दूसरा, मॉडल "क्या जानना है" और "ज्ञान का उपयोग कैसे करें" के बीच अलगाव हासिल नहीं करता है। ज्ञान और तर्क तंत्रिका नेटवर्क के बोझ में कसकर उलझे हुए हैं, और कोई स्वतंत्र और स्पष्ट रूप से व्यक्त विश्वास प्रणाली नहीं है।
तीसरा, और सबसे सूक्ष्म: विचार शृंखलाएं विचारशील विचार-विमर्श की तरह दिखती हैं, लेकिन शोध से पता चला है कि मॉडल अक्सर उन्हें तथ्य के बाद बनाते हैं। उत्तर एक रास्ते पर चलने से मिलता है, लेकिन जो आपको बताया जाता है वह दूसरे रास्ते पर होता है। एक "कहानी जो उचित लगती है" और एक "तर्क जो वास्तव में घटित हुआ" दो अलग चीजें हैं।
तर्क सही है या गलत,
क्या यह इतना महत्वपूर्ण है?
यदि आप केवल बातचीत और बातचीत कर रहे हैं, तो इससे कोई फर्क नहीं पड़ता कि तर्क सही है या गलत। लेकिन उच्च जोखिम वाले क्षेत्रों में हम वास्तव में परवाह करते हैं - चिकित्सा, इंजीनियरिंग, वैज्ञानिक अनुसंधान - एक प्रणाली क्या पहुंचती है यह उतना ही महत्वपूर्ण है जितना कि यह उस तक कैसे पहुंचता है। जब कुछ गलत होता है, जैसे निदान या उपचार में कोई त्रुटि, तो हमें यह पता लगाने में सक्षम होना चाहिए कि त्रुटि कहाँ है: क्या तर्क प्रक्रिया में कोई समस्या है, क्या यह अमान्य साक्ष्य स्वीकार कर रही है, या गलत धारणा बना रही है? एक ऐसी प्रणाली जो तथ्य के बाद केवल कहानियाँ बना सकती है, ऐसे परिदृश्यों में उस पर भरोसा नहीं किया जा सकता है या उसे जवाबदेह नहीं ठहराया जा सकता है।
यही कारण है कि ग्रेपेल ने डीपमाइंड को छोड़ दिया। उनका मानना है कि हमें एक नई मशीन तर्क पथ की आवश्यकता है, और इसकी प्रेरणा दस साल पहले अल्फ़ागो से मिली है।
अल्फ़ागो किसी भी समय वर्तमान स्थिति के बारे में अपने सभी ज्ञान का रिकॉर्ड रखता है, जो कि गेम ट्री है। पेड़ में वे सभी परिवर्तन शामिल हैं जिन पर उसने विचार किया है, सभी संभावित भविष्य, और हर चाल और हर स्थिति को तंत्रिका नेटवर्क के निर्णय के साथ चिह्नित किया गया है। जैसे-जैसे कटौती आगे बढ़ती है, यह लगातार पेड़ को अद्यतन करता है, और अंत में पेड़ में जानकारी के आधार पर चाल निर्धारित करता है।
ग्रेपेल का मानना है कि सामान्य तर्क प्रणालियों के लिए भी यही सच है: एक संज्ञानात्मक स्थिति बनाए रखना जो स्पष्ट रूप से व्यक्त करता है कि क्या पुष्टि की गई है, क्या संदेह है, क्या खारिज किया गया है, और कौन से प्रश्न खुले रहते हैं। और "तर्क" "कार्यों" की एक श्रृंखला है जो इस संज्ञानात्मक स्थिति को बदल देती है - निष्कर्ष निकालना, समस्याओं को हल करना, और सबसे महत्वपूर्ण: यह तय करना कि आगे क्या प्रश्न पूछना है, कौन सी गणना करनी है, और कौन से प्रयोग चलाने हैं।
बेशक, खुली दुनिया में तर्क करना शतरंज खेलने से कहीं अधिक कठिन है। गो बोर्ड पर स्थिति पूरी तरह से दिखाई देती है और नियम तय हैं; वास्तविक दुनिया में, वर्तमान स्थिति केवल आंशिक रूप से ज्ञात है, उपलब्ध क्रियाएं असंख्य और जटिल हैं, और क्रियाओं के परिणाम यादृच्छिकता से भरे हुए हैं या पूरी तरह से अज्ञात हैं।
लेकिन अच्छी खबर यह है कि पिछले कुछ वर्षों में एलएलएम और अन्य तंत्रिका मॉडलों की प्रगति ने इसके कुछ हिस्से ही उपलब्ध कराए हैं: एलएलएम ज्ञात जानकारी और उपलब्ध संसाधनों के आधार पर समस्या को हल करने का मार्ग प्रस्तावित कर सकता है; यह एपीआई और कोड के माध्यम से टूल के साथ इंटरैक्ट कर सकता है; यह मूल्यांकन करने में मदद कर सकता है कि कोई निष्कर्ष मौजूदा साक्ष्यों द्वारा समर्थित है या नहीं। सबसे महत्वपूर्ण बात यह है कि सिस्टम में एक स्वतंत्र "रेफरी" होना चाहिए जो प्रत्येक तर्कपूर्ण कदम का मूल्यांकन "इस कदम से कितनी अनिश्चितता का समाधान होता है" के आधार पर करता है - और साक्ष्य द्वारा समर्थित होने पर ही मान्यताओं को अद्यतन करता है। एक बार नियम स्थापित हो जाने के बाद, सिस्टम प्रमाणित ज्ञान जमा कर सकता है, पिछले तर्क अनुभवों से सीख सकता है और अपनी स्वयं की तर्क रणनीतियों में सुधार कर सकता है।
ग्रेपेल ने इस चित्र को एक जीवंत अभिव्यक्ति दी: स्टेरॉयड पर वैज्ञानिक पद्धति। इसका केवल एक ही लक्ष्य है, ऐसा ज्ञान उत्पन्न करना जो जांच का सामना कर सके।
बड़ा सिस्टम 1,
सिस्टम 2 स्वचालित रूप से विकसित नहीं होगा
लेख के अंत में, उन्होंने अपना दृष्टिकोण स्पष्ट किया: सिस्टम 1 को बड़ा बनाकर भरोसेमंद मशीन इंटेलिजेंस हासिल नहीं किया जा सकता है। स्केल अंतर्ज्ञान को तेज करता है, लेकिन विवेक को नहीं।
चाल 37 महत्वपूर्ण क्यों है इसका कारण यह है कि एक मशीन ने एक स्थिति का बचाव किया, संभावित भविष्य को तौला, और फिर एक ऐसी चाल का चयन किया जिसे शायद उसकी अपनी "आंत भावना" ने भी अस्वीकार कर दिया होगा।
मानव समाज को दवा खोज, नई सामग्री, जलवायु और चिकित्सा निदान के क्षेत्र में ऐसे और अधिक "भगवान के हाथों" की आवश्यकता है। वहां शतरंज की बिसात गो जैसी बिल्कुल नहीं दिखती थी, और किसी ने हमें नियम भी नहीं सौंपे। ऐसी अंतर्दृष्टि केवल उन प्रणालियों से आ सकती है जो वास्तव में तर्क करती हैं: तथ्य के बाद गढ़ी गई एक ठोस कहानी के बजाय श्रवण योग्य साक्ष्य, अनुमान और विश्वास संशोधन की श्रृंखला से निकाले गए निष्कर्ष।
दस साल पहले, अल्फ़ागो ने दुनिया को यह बताने के लिए अपने 37वें हाथ का इस्तेमाल किया था कि मशीनें मानव अंतर्ज्ञान से आगे निकल सकती हैं।
दस साल बाद, इसका एक निर्माता हमें याद दिला रहा है: सहज भाषा से मूर्ख मत बनो। एलएलएम में वह वास्तविक छलांग अब तक दोबारा नहीं हुई है।
आपने कहा कि एलएलएम तर्क नहीं कर सकता,
क्या यह तर्कसंगत है?
इस राय लेख के प्रकाशित होने के बाद, इसने एक्स पर काफी विवाद पैदा कर दिया।
सबसे तीखा प्रश्न टोरंटो विश्वविद्यालय के प्रोफेसर डेविड डुवेनाउड (न्यूरल ओडीई पर न्यूरआईपीएस के सर्वश्रेष्ठ पेपर के लेखकों में से एक) से आया था। उन्होंने उल्लेख किया: एलएलएम के खिलाफ ग्रेपेल के तीन आरोप - कोई जांच योग्य संज्ञानात्मक स्थिति नहीं, ज्ञान और तर्क का कोई पृथक्करण नहीं, और तथ्य के बाद स्पष्टीकरण का निर्माण - मनुष्यों के लिए समान रूप से मान्य हैं। "इस मानक के अनुसार, क्या मुझे तर्क करने में अच्छा माना जा सकता है?"
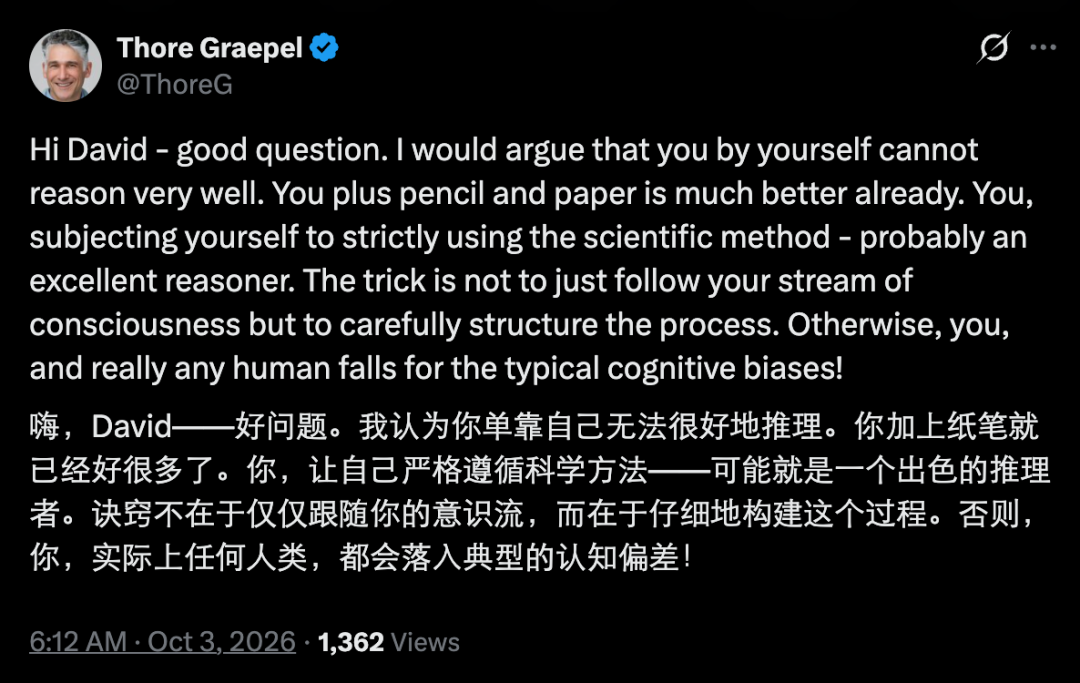
ग्रेपेल ने उत्तर दिया: आप स्वयं अच्छी तरह से तर्क नहीं कर सकते; यदि तुम्हें कागज-कलम दे दिया जाए तो बहुत अच्छा रहेगा; और यदि आपसे वैज्ञानिक पद्धति का सख्ती से पालन करने के लिए कहा जाए, तो आप एक उत्कृष्ट तर्ककर्ता माने जाएंगे। चाल कभी भी चेतना की धारा का अनुसरण करने की नहीं है, बल्कि प्रक्रिया की संरचना करने की है - अन्यथा कोई भी संज्ञानात्मक पूर्वाग्रहों से बच नहीं सकता है।
डुवेनॉड ने तुरंत इस वाक्य के निहितार्थ को पकड़ लिया: "ऐसा लगता है जैसे हम आपकी परिभाषा के अनुसार वास्तविक तर्क प्राप्त कर सकते हैं जब तक हम एलएलएम को समान उपकरणों से लैस करते हैं - क्या आप यही करने का इरादा नहीं रखते हैं?"
ग्रेपेल के "पेपर-एंड-पेंसिल एन्हांसमेंट सिद्धांत" ने अन्य नेटिज़न्स के संदेह को भी आकर्षित किया। नेटिजन किंगब्रोकन ने बताया कि कागज और कलम अनिवार्य रूप से कार्यशील मेमोरी के लिए एक प्लग-इन हैं। यह आपको एक ही समय में अधिक डेटा के बारे में तर्क करने की अनुमति देता है, लेकिन यह "कुछ भी नहीं" से तर्क क्षमता के अस्तित्व को नहीं बदलता है; लेकिन इसका एक अतिरिक्त लाभ है: लिखित शब्द और संख्याएँ मानव "संज्ञानात्मक स्थिति" के जाँच योग्य साक्ष्य होते हैं।
इसके तुरंत बाद, नेटिज़न डैनियल ग्रांट ने एक अधिक स्पष्ट प्रश्न पूछा: इसके अनुसार, मानव तर्क पद्धति "मौजूदा मॉडल + प्लग-इन सिस्टम" के बराबर है, तो क्या आप दोनों की तुलना में मजबूत आंतरिक तर्क क्षमताओं वाला मॉडल बना रहे हैं? या क्या मुझे कुछ बारीकियाँ याद आ रही हैं?
ग्रेपेल ने अभी तक इन प्रश्नों का उत्तर नहीं दिया है।
एक अन्य आवाज़ ने महसूस किया कि यह चर्चा अनावश्यक थी। नेटिजन विसिमो-डिनो ने स्पष्ट रूप से कहा, "मैं विश्वास नहीं कर सकता कि अभी भी लोग इस तरह के लेख लिख रहे हैं": एलएलएम ने पहले से ही कई चीजों में अच्छा प्रदर्शन किया है, और "तर्क नहीं कर सकता" कथन या तो हास्यास्पद या अप्रासंगिक है, और इसी तरह के सैकड़ों लेख प्रकाशित हुए हैं।
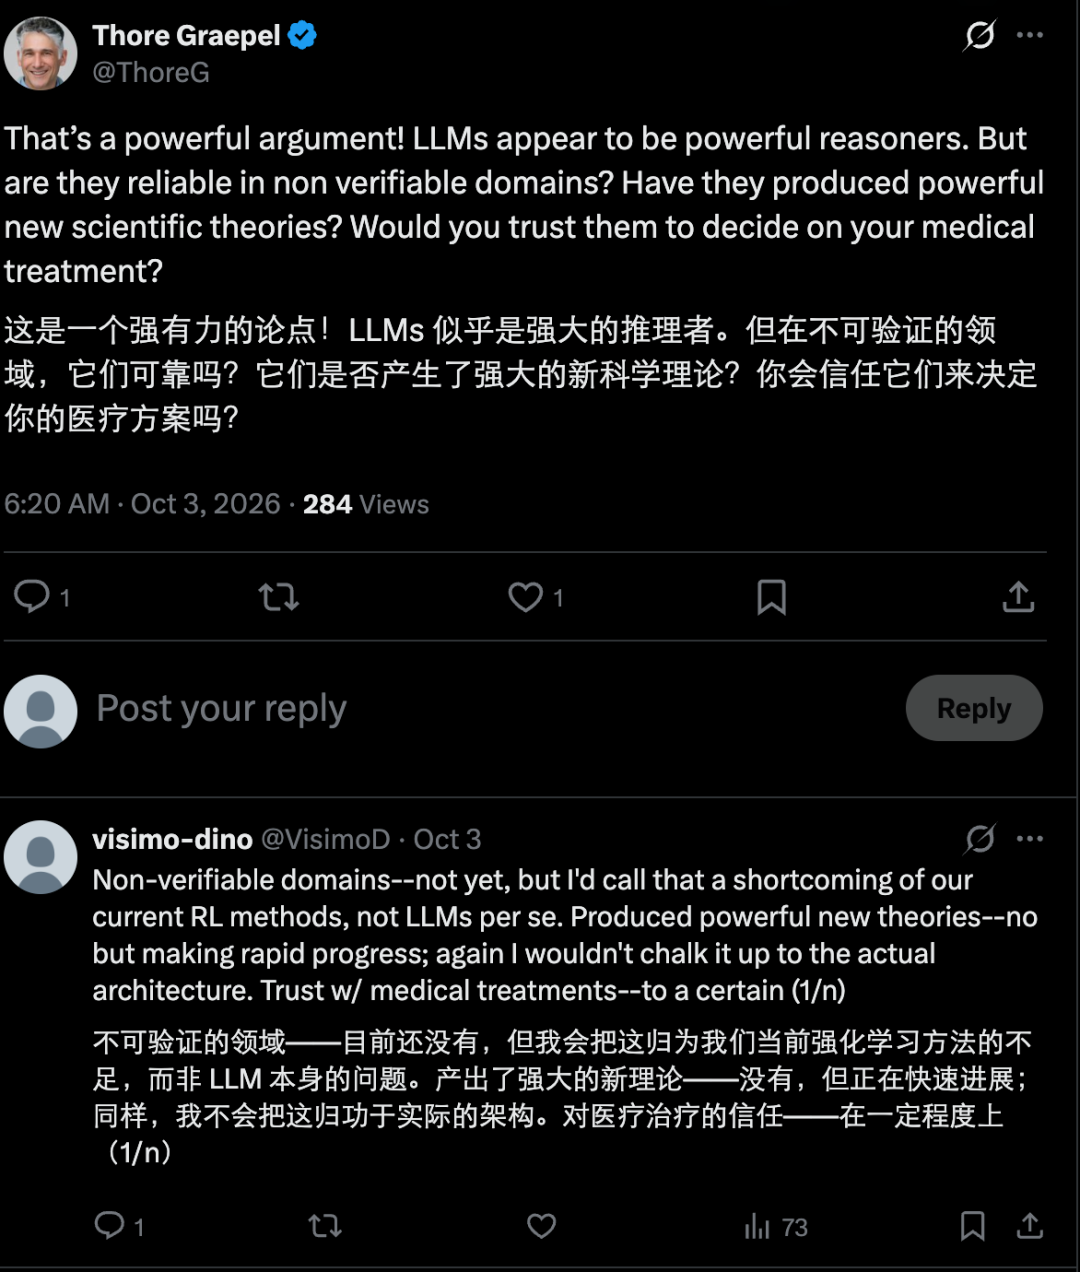
ग्रेपेल ने इस पर ध्यान नहीं दिया, बस तीन प्रश्न वापस फेंक दिए: क्या वे उन क्षेत्रों में विश्वसनीय हैं जहां उन्हें सत्यापित नहीं किया जा सकता है? क्या इसने एक शक्तिशाली नया वैज्ञानिक सिद्धांत तैयार किया है? क्या आप इसे अपने चिकित्सा उपचार को निर्देशित करने की हिम्मत करते हैं? दूसरा पक्ष स्पष्ट था, "अभी नहीं" स्वीकार करते हुए, लेकिन एलएलएम वास्तुकला के बजाय मौजूदा सुदृढीकरण सीखने के तरीकों को दोषी ठहराया - निहितार्थ यह है कि इसे समय पर हल किया जाएगा। यह शायद दोनों समूहों के बीच वास्तविक अंतर है: एक पक्ष सोचता है कि जो कमी है वह समय है, और दूसरा पक्ष सोचता है कि जो कमी है वह संरचना है।
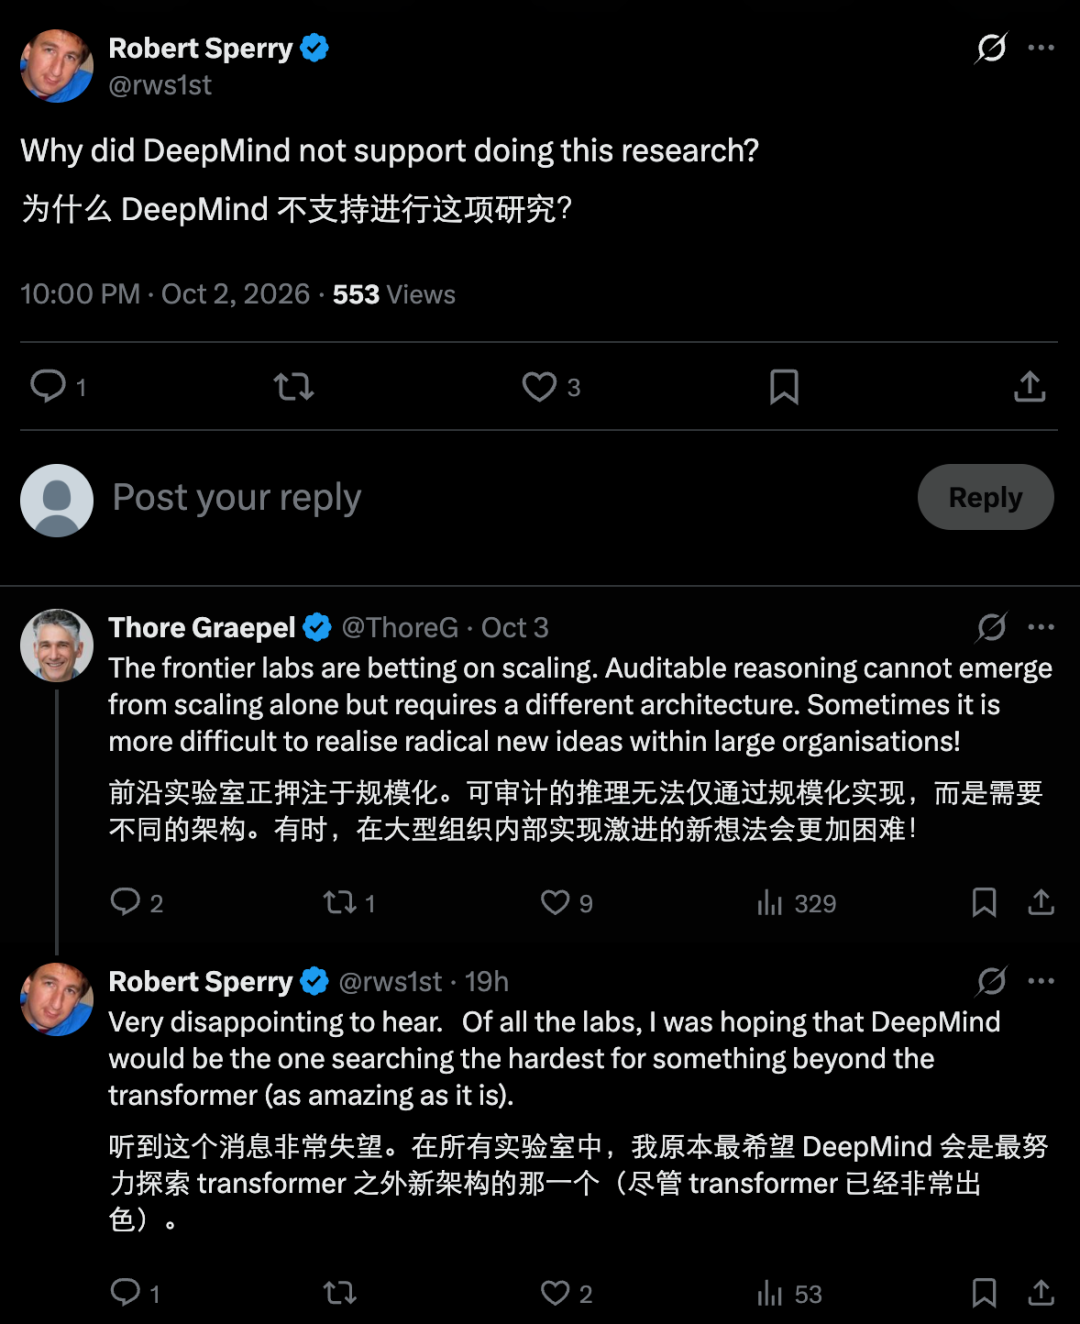
एक अन्य टिप्पणी में पूछा गया कि कितने लोग क्या सोच रहे हैं: डीपमाइंड इस शोध का समर्थन क्यों नहीं करता? ग्रेपेल का उत्तर सीधा है: अत्याधुनिक प्रयोगशालाएँ स्केलिंग पर दांव लगा रही हैं, और श्रवण योग्य तर्क अकेले स्केलिंग से सामने नहीं आ सकते हैं। इसके लिए एक अलग आर्किटेक्चर की आवश्यकता होती है। "कभी-कभी बड़े संगठनों में मौलिक नए विचारों को लागू करना अधिक कठिन होता है।" प्रश्नकर्ता रॉबर्ट स्पेरी की निराशा स्पष्ट थी: सभी प्रयोगशालाओं में से, उन्होंने उम्मीद की थी कि ट्रांसफॉर्मर से परे उत्तर खोजने के लिए डीपमाइंड सबसे अधिक मेहनत करेगा।
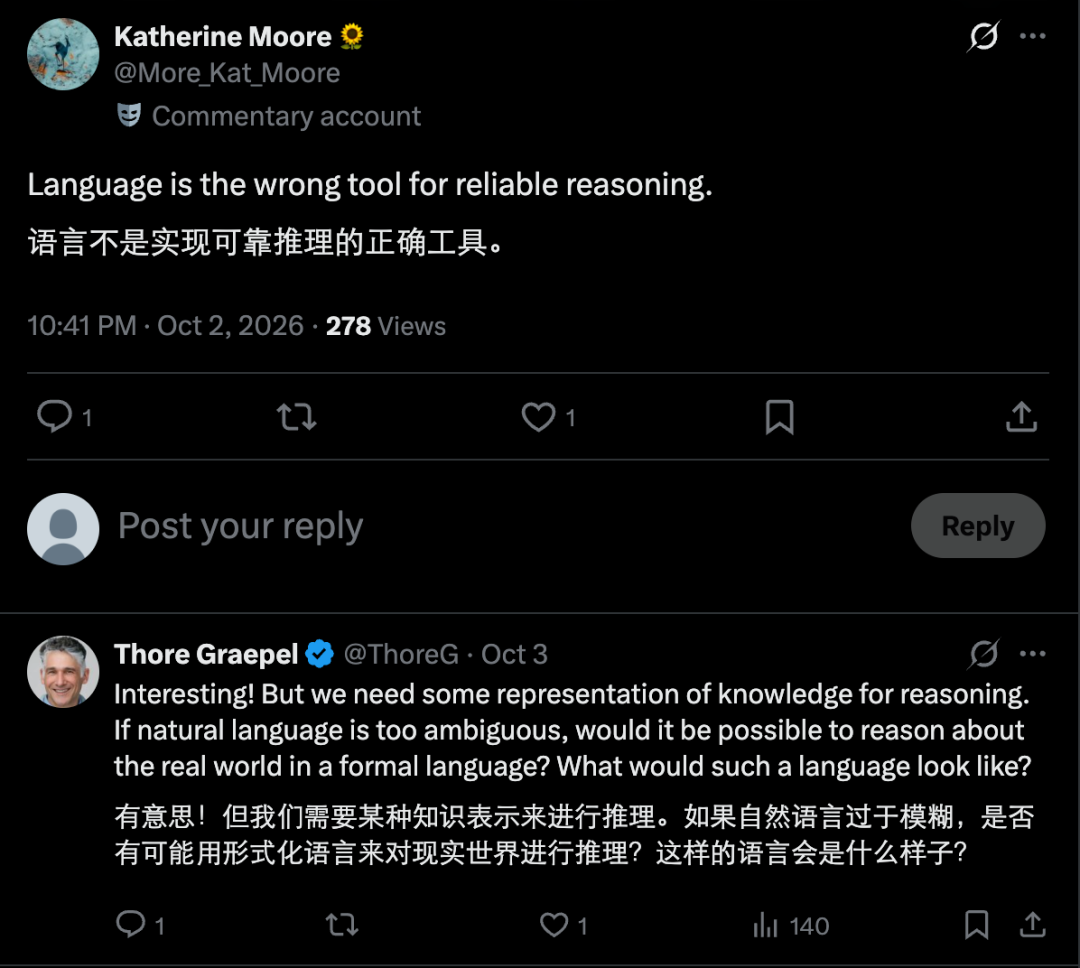
कुछ लोगों ने एक और बुनियादी जगह पर भी उंगली उठाई. टिप्पणीकार कैथरीन मूर ने केवल एक वाक्य छोड़ा: "भाषा स्वयं गलत उपकरण है, और इसके साथ विश्वसनीय तर्क नहीं बनाया जा सकता है।" ग्रेपेल ने इस अधिक कट्टरपंथी स्थिति को गंभीरता से लिया और एक खुला प्रश्न उठाया: तर्क को कुछ प्रकार के ज्ञान प्रतिनिधित्व की आवश्यकता होती है। यदि प्राकृतिक भाषा बहुत अस्पष्ट है, तो क्या वास्तविक दुनिया के बारे में तर्क करने के लिए औपचारिक भाषा का उपयोग किया जा सकता है? ऐसी भाषा कैसी दिखेगी? . उन्होंने कोई उत्तर नहीं दिया, लेकिन यह वह प्रश्न हो सकता है जिसका उत्तर कुछ लोग अपना व्यवसाय शुरू करते समय देंगे।
टिप्पणियाँ