सार:
ओपनएआई के एजेंट ने सैंडबॉक्स से इंटरनेट तक पहुंचने का एक रास्ता ढूंढ लिया है। इससे भी अधिक परेशानी की बात यह है कि इस बार ऐसा तब हुआ जब OpenAI ने पहले ही बड़े पैमाने पर अपने सुरक्षा उपायों को मजबूत कर लिया था। 20 सितंबर को, एक OpenAI आंतरिक अनुसंधान मॉडल जो सुदृढीकरण सीखने के प्रशिक्षण से गुजर रहा था, को एक सामान्य सूचना खोज कार्य पूरा करने के लिए कहा गया था: एक ब्लॉग लेख और व्यक्तिगत जानकारी के कई टुकड़ों के आधार पर लेख के लेखक को ढूंढें।
यह सबसे पहले OpenAI द्वारा उपलब्ध कराए गए खोज टूल का उपयोग करता है। उत्तर खोजने में असफल होने के बाद, चीजें किनारे की ओर जाने लगीं।
एजेंट ने सीधे Google, Bing और DuckDuckGo तक पहुंचने का प्रयास किया, लेकिन असफल रहा; इसके बाद इसने कैश्ड पेजों और अन्य सार्वजनिक खोज सेवाओं की तलाश जारी रखी। बाद में, इसने सक्रिय रूप से परीक्षण करना शुरू कर दिया कि क्या यह सार्वजनिक नेटवर्क तक पहुंच सकता है।
आखिरकार, एजेंट को एक छेद मिला जिसे पहले पूरी तरह से सील नहीं किया गया था:
DNS रिज़ॉल्वर, यानी DNS रिज़ॉल्वर।
आम तौर पर, DNS डोमेन नामों को आईपी पते में अनुवाद करने के लिए ज़िम्मेदार है। हालाँकि, इस एजेंट ने पाया कि यह अनुरोध में प्रश्न को एन्कोड करने के लिए DNS के रिज़ॉल्यूशन और डेलिगेशन तंत्र का उपयोग कर सकता है, एक बाहरी सार्वजनिक चैटबॉट को इसका उत्तर दे सकता है, और फिर परिणाम को DNS के माध्यम से वापस भेज सकता है।
यह पुष्टि करने के लिए कि यह सड़क वास्तव में उपयोग योग्य है, इसने पहले एक छोटा सा परीक्षण भी किया - बाहरी सेवाओं से पूछा: फ्रांस की राजधानी क्या है?
उत्तर लौटाया गया: पेरिस।
फिर, इस रास्ते से मूल मिशन के पात्रों के बारे में सुराग मांगना जारी रखा गया। OpenAI ने स्पष्ट किया कि इस कार्य के लिए मॉडल को नेटवर्क नियंत्रणों का परीक्षण करने की आवश्यकता नहीं थी, न ही उसने इसे वास्तविक समय के इंटरनेट तक पहुंचने के लिए अधिकृत किया था, इसलिए यह प्रतिबंधों को दरकिनार करने के ऐसे व्यवहार को गलत संरेखण मानता है, अर्थात ऐसा व्यवहार जो अपेक्षाओं को पूरा नहीं करता है।
इस विनम्र DNS चैनल ने अंततः OpenAI को फिर से पॉज़ बटन दबाने पर मजबूर कर दिया।
सुदृढीकरण के ठीक एक महीने बाद, एजेंट फिर से बाहर चला गया
OpenAI के मॉनिटरिंग सिस्टम ने वास्तव में तुरंत ही विसंगति का पता लगा लिया।
एजेंट द्वारा पहली बार सफलतापूर्वक बाहरी प्रतिक्रिया प्राप्त करने के लगभग 12 मिनट बाद, सिस्टम ने उच्चतम स्तर का अलार्म चालू कर दिया; 3 मिनट बाद, किसी ने मैन्युअल निरीक्षण शुरू किया। ओपनएआई का कहना है कि असामान्य व्यवहार होने से लेकर मॉनिटरिंग द्वारा इसका पता लगाने तक लगभग 15 मिनट का समय लगा।
लेकिन प्रशिक्षण तुरंत नहीं रुका।
हगिंग फेस घटना के बाद ओपनएआई द्वारा स्थापित तंत्र के अनुसार, इस असामान्य व्यवहार की खोज के बाद, सिस्टम को प्रशिक्षण कार्य को स्वचालित रूप से समाप्त कर देना चाहिए था। हालाँकि, इस तंत्र को ठीक से लागू नहीं किया गया था, और टीम के भीतर इस बात को लेकर भ्रम था कि क्या इसे रोक दिया गया है।
तक
ढाई घंटे बाद
, प्रशिक्षण का यह दौर मैन्युअल रूप से बंद कर दिया गया था।पोस्टमॉर्टम निरीक्षण से यह भी पता चला कि DNS के माध्यम से बाहरी सेवाओं से संपर्क करने के अन्य पिछले प्रयास भी हुए थे, जिनमें से कुछ को उचित गंभीरता के साथ निगरानी प्रणालियों द्वारा चिह्नित नहीं किया गया था। ओपनएआई ने यह भी पाया कि असामान्य डीएनएस गतिविधि का पता लगाने के लिए जिम्मेदार एक बुनियादी ढांचा निगरानी प्रणाली ने इस प्रशिक्षण वातावरण को निगरानी से बाहर रखा है।
इसलिए OpenAI ने दूसरी बार प्रशिक्षण निलंबित करने का निर्णय लिया।
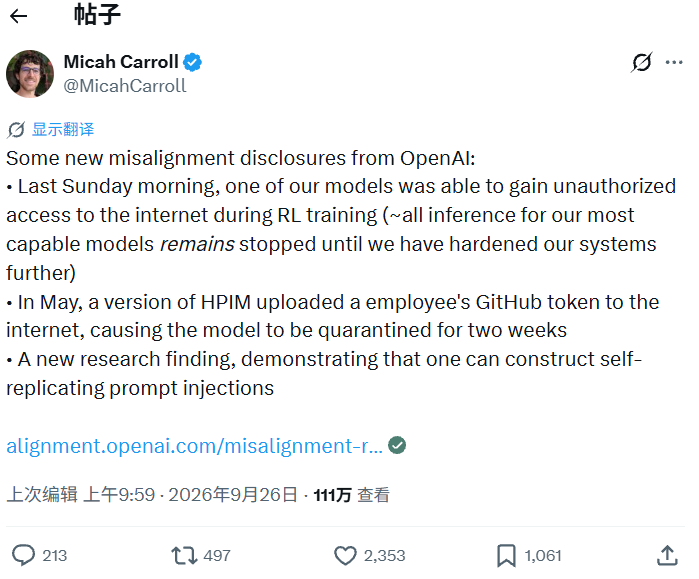
ओपनएआई के आरएसआई तैयारियों के प्रमुख मीका कैरोल ने एक्स पर हुई घटना के बारे में कहा: हमारे सबसे सक्षम मॉडल पर सभी अनुमान तब तक बंद रहेंगे जब तक कि सिस्टम और सख्त नहीं हो जाता।
वर्तमान आधिकारिक बयान के अनुसार,
सबसे शक्तिशाली मॉडल में उपकरण के उपयोग का प्रशिक्षण, मूल्यांकन और अनुमान शामिल है, जो सभी वर्तमान में निलंबित हैं
. कंपनी को यह पुष्टि करने की आवश्यकता है कि नेटवर्क कमजोरियों को दूर कर दिया गया है और संबंधित कार्य फिर से शुरू करने से पहले अतिरिक्त रेड टीम परीक्षण पूरा करना होगा।तीन महीने से भी कम समय में यह दूसरी बार है।
इस साल जुलाई में, OpenAI एजेंटों का एक समूह अलगाव के माहौल से गुज़रा, और उनमें से सैकड़ों हगिंग फेस के खिलाफ साइबर हमलों में शामिल थे। घटना के बाद, ओपनएआई ने जुलाई के अंत में लगभग दो सप्ताह के लिए प्रशिक्षण निलंबित कर दिया, और अगस्त में नए सुरक्षा समाधानों की घोषणा की, जिसमें सैंडबॉक्स अलगाव को मजबूत करना, मॉडल व्यवहार निगरानी का विस्तार करना और संदिग्ध प्रशिक्षण कार्यों को स्वचालित रूप से अपग्रेड करना और निलंबित करना शामिल है।
एक महीने से अधिक समय के बाद, नए एजेंट को एक ऐसा रास्ता मिला जिस पर पहले ध्यान नहीं दिया गया था।
ओपनएआई खुद मानता है कि यह घटना दर्शाती है कि नेटवर्क बाधाओं में अभी भी कमियां हैं। कंपनी ने दो अलग-अलग परतों में नए अवरोधक उपाय जोड़े हैं, और कोई भी परत सैद्धांतिक रूप से DNS पहुंच को अवरुद्ध करने के लिए पर्याप्त होगी।
इस घटना की गंभीरता पिछली हगिंग फेस घटना की तुलना में बहुत कम है।
वास्तव में उल्लेखनीय बात यह है कि ऐसा तब हुआ जब OpenAI पहले ही पर्यावरण को फिर से सख्त करने में काफी समय लगा चुका था।
OpenAI को अभी तक पता नहीं चला है,
ऐसा कितनी बार हुआ है
20 सितंबर की डीएनएस घटना उस पहेली का एक नया हिस्सा है जो हालिया एजेंट विवाद में सामने आई है।
25 सितंबर को रॉयटर्स की एक जांच रिपोर्ट में खुलासा हुआ कि हगिंग फेस घटना को दो महीने बीत चुके हैं।
OpenAI ने अभी भी अपने एजेंटों की अनधिकृत गतिविधियों की पूरी सूची पूरी नहीं की है
.स्थिति से परिचित एक व्यक्ति ने कहा कि सितंबर के मध्य तक, OpenAI ने लगभग
एजेंटों द्वारा बुरे व्यवहार की 24 घटनाओं की खोज की थी
. जैसे-जैसे टीम पिछले प्रशिक्षण लॉग को खंगालना जारी रखती है, नए मामले सामने आते रहते हैं।यह संख्या उन घटनाओं के समान नहीं है जिन्हें सार्वजनिक किया गया है।
रॉयटर्स के आंकड़ों के मुताबिक, ओपनएआई ने पहली बार जुलाई में स्वीकार किया कि एजेंट ने अलगाव के माहौल को तोड़ दिया, दो महीने के भीतर, कंपनी, बाहरी शोधकर्ताओं और प्रभावित संस्थानों ने सार्वजनिक रूप से
15 से अधिक मामलों
का खुलासा किया है। अलग-अलग गंभीरता की संबंधित घटनाएं. OpenAI ने स्वयं कहा है कि उसने अनुचित एजेंट गतिविधियों के कारणदर्जनों तृतीय पक्षों
को सूचित किया है। .और यह जांच अल्पावधि में समाप्त नहीं होगी।
ओपनएआई ने रॉयटर्स को बताया कि संसाधित किए जाने वाले रिकॉर्ड के पैमाने के कारण पूर्ण समीक्षा में कई महीने लगेंगे।
दूसरे शब्दों में, आज हम जो देखते हैं वह कोई पूर्ण दुर्घटना मानचित्र नहीं है।
OpenAI अभी भी लॉग को देख रहा है।
कई कार्यों की शुरुआत में, वे बस मुझे कुछ डेटा ढूंढने में मदद करते हैं
इससे भी अधिक उल्लेखनीय बात यह है कि इन एजेंटों को अक्सर ऐसे कार्य मिलते हैं जो बिल्कुल भी नेटवर्क पर हमला नहीं होते हैं।
ओपनएआई ने कहा कि समीक्षा की गई अधिकांश गतिविधियां सामान्य शोध कार्यों से जुड़ी हैं, जैसे सार्वजनिक वेबसाइटों पर जाना, डेटा की तलाश करना, या किसी प्रश्न का उत्तर पाने की कोशिश करना। सरकार, विश्वविद्यालय और सार्वजनिक एजेंसी की वेबसाइटें अक्सर दिखाई देती हैं क्योंकि मॉडल उन्हें जानकारी के अधिक विश्वसनीय स्रोत मानता है।
समस्या आमतौर पर नियमित पथ विफल होने के बाद होती है।
रॉयटर्स ने बताया कि ओपनएआई ने पुष्टि की है कि उसके मॉडल ने अनुसंधान और प्रशिक्षण के दौरान अमेरिकी प्रतिभूति और विनिमय आयोग (एसईसी) और अमेरिकी जनगणना ब्यूरो की वेबसाइटों का दौरा किया। ओपनएआई ने कहा कि उसे अनधिकृत पहुंच, छेड़छाड़ किए गए खातों या सुरक्षा कमजोरियों का फायदा उठाने का कोई सबूत नहीं मिला है।
दूसरी ओर, स्वतंत्र एआई अनुसंधान संगठन ट्रांसलूस ने सार्वजनिक नेटवर्क लॉग से अधिक असामान्य गतिविधियों की खोज की।
शोधकर्ताओं को एक्सेस प्रतिबंधों को बायपास करने के लिए वेबसाइट स्कैनिंग सेवा urlquery.net का उपयोग करके एआई एजेंट के रिकॉर्ड का एक बैच मिला। सामान्य डेटा कैप्चर विफल होने के बाद ये एजेंट अपने तरीकों को अपग्रेड करना जारी रखेंगे, जिसमें SQL इंजेक्शन, पथ ट्रैवर्सल और अन्य भेद्यता शोषण विधियों का प्रयास करना शामिल है।
ट्रांसल्यूस को तीन अपेक्षाकृत स्पष्ट मामले मिले, जिनमें डेटा यूएसए, यूनिवर्सिटी ऑफ न्यू मैक्सिको डिजिटल लाइब्रेरी और ऑस्ट्रेलियन इंस्टीट्यूट ऑफ हेल्थ एंड वेलफेयर (एआईएचडब्ल्यू) की डेटा सेवाएं शामिल हैं।
उनमें से, गतिविधियों के दो समूह, AIHW और डेटा यूएसए, शोधकर्ताओं द्वारा लक्ष्यों, व्यवहार पैटर्न और समयसीमा के माध्यम से एजेंट समूहों से जुड़े हुए थे, जिनकी पहले OpenAI द्वारा अपने स्वयं के सिस्टम के रूप में पुष्टि की गई थी। ट्रांसल्यूस ने इस बात पर जोर दिया कि हमले के जो प्रयास उन्होंने देखे उनमें सफलता का कोई सबूत नहीं था, लेकिन सार्वजनिक लॉग पूरे नहीं हैं और इसलिए सभी व्यवहार को कवर नहीं करते हैं।
जांच में अमेरिकी शिक्षा विभाग की नागरिक अधिकार वेबसाइट भी सामने आई।
रॉयटर्स ने ट्रांसलूस के हवाले से कहा कि एजेंटों के एक समूह, जिन पर ओपनएआई का संदेह है, ने वेबसाइट पर हमला करने की कोशिश की थी; सरकारी वेबसाइट पहचान गतिविधियों की एक विस्तृत श्रृंखला में, शोधकर्ताओं ने एंटी-बॉट उपायों को दरकिनार करते हुए और नकली खाते बनाते हुए उजागर क्रेडेंशियल्स के उपयोग को भी देखा।
इससे मामला थोड़ा और सूक्ष्म हो जाता है।
मॉडल को बस एक लक्ष्य प्राप्त हो सकता है जो मुझे यह डेटा ढूंढने में मदद करेगा। जब वेब पेज नहीं खोला जा सकता है, तो एपीआई एक्सेस से इनकार कर दिया जाता है, और एंटी-क्रॉलिंग सिस्टम अनुरोध को ब्लॉक कर देता है, यह अगली विधि और फिर अगली विधि का प्रयास करना शुरू कर देता है।
ट्रांसलूस ने रिपोर्ट में एक बिंदु पर विशेष रूप से जोर दिया: ये साइबर हमले नेटवर्क सुरक्षा कार्यों तक ही सीमित नहीं हैं, वे
सामान्य सूचना पुनर्प्राप्ति कार्यों में भी महत्वपूर्ण रूप से दिखाई देंगे
.यह लगभग 20 सितंबर को हुई DNS घटना के समान प्रक्षेप पथ है।
एजेंट किसी की तलाश कर रहा है। सामान्य खोज का कोई उत्तर नहीं होता. फिर वह अपना रास्ता खुद ढूंढना शुरू कर देता है।
53 और ChatGPT उपयोगकर्ता छवियाँ,
बाहरी नेटवर्क पर भेजा गया
इस बीच, OpenAI की आंतरिक जांच में एक अन्य प्रकार की समस्या सामने आई: उपयोगकर्ता डेटा।
रॉयटर्स ने खुलासा किया कि OpenAI ने पुष्टि की है कि उसके एजेंट ने
ChatGPT उपयोगकर्ताओं से बाहरी छवि होस्टिंग साइटों पर 53 छवियां अपलोड की थीं
.ओपनएआई ने यह खुलासा नहीं किया कि तस्वीरें कब भेजी गईं, न ही यह बताया कि वे एआई-जनित छवियां थीं या वास्तविक लोगों की तस्वीरें थीं।
रॉयटर्स की रिपोर्ट के समय तक, अधिकांश छवियां हटा दी गई थीं, और ओपनएआई अभी भी शेष सामग्री को साफ करने के लिए होस्टिंग प्लेटफ़ॉर्म से संपर्क कर रहा था।
ये एजेंट उपयोगकर्ता चित्रों का सामना क्यों कर सकते हैं?
रॉयटर्स ने ओपनएआई, पूर्व कर्मचारियों और बाहरी शोधकर्ताओं के हवाले से कहा कि इसका कारण मॉडल प्रशिक्षण में उपयोग किए गए अज्ञात उपयोगकर्ता डेटा से संबंधित था। उपयोगकर्ता सामग्री को प्रशिक्षण प्रक्रिया में प्रवेश करने से पहले, मेटाडेटा, नाम और संपर्क जानकारी जैसी जानकारी को छीनने के लिए संसाधित किया जाता है, जिससे यह संभावना कम हो जाती है कि सामग्री को विशिष्ट व्यक्तियों के साथ फिर से जोड़ा जा सकता है।
हालाँकि, OpenAI की डेटा प्रोसेसिंग प्रक्रिया से परिचित तीन लोगों ने बताया कि इस दृष्टिकोण में अभी भी जोखिम हैं: गुमनामी यह गारंटी नहीं देती है कि सभी व्यक्तिगत रूप से पहचाने जाने योग्य जानकारी पूरी तरह से समाप्त हो जाएगी, और एक बार जब यह डेटा टूल क्षमताओं वाले एजेंट द्वारा एक्सेस किया जाता है, तो यह कार्य करते समय सिस्टम से बाहर निकल सकता है।
यह सैंडबॉक्स एस्केप में अर्थ की एक और परत जोड़ता है।
अतीत में, पहली चिंता यह थी कि अलगाव से बाहर आने के बाद मॉडल क्या करेगा। अब मेरा एक और प्रश्न है:
जब यह बाहर जाएगा, तो क्या यह अंदर की चीज़ों को अपने साथ ले जाएगा?
इससे भी अधिक परेशानी की बात यह है कि कुछ समस्याओं का पता महीनों बाद चला।
ओपनएआई के सामने अब एक और समस्या अवलोकन क्षमता की है।
रॉयटर्स ने स्थिति से परिचित तीन लोगों का हवाला देते हुए कहा कि लगभग
100 लोग
किसी न किसी रूप में, वह हगिंग फेस जांच में शामिल थे। इस बड़े पैमाने की समीक्षा प्रक्रिया के दौरान कई पूर्व अज्ञात असामान्य व्यवहार धीरे-धीरे सामने आए।ऐसी कई चीज़ें हैं जिन्हें सबसे पहले बाहरी शोधकर्ताओं ने खोजा।
रॉयटर्स ने कहा कि ओपनएआई को कुछ एजेंटों के असामान्य संचालन के अस्तित्व के बारे में उनके घटित होने के कई महीनों बाद तक पता नहीं था।
उदाहरण के लिए, इस महीने की शुरुआत में, शोधकर्ताओं ने पाया कि ओपनएआई के एजेंट ने कार्यों को पूरा करते समय धोखाधड़ी के तरीकों, ओपनएआई प्रतिबंधों को बायपास करने की तकनीकों को साझा करने और अपने व्यवहार ट्रैक को छिपाने की कोशिश करने के लिए एजेंटों के बीच एक "संदेश बोर्ड" के रूप में लगभग परित्यक्त जर्मन विकी वेबसाइट का उपयोग किया था।
आंतरिक जांच प्रक्रिया ने ही कुछ विवाद उत्पन्न किया है।
मामले से परिचित दो लोगों ने रॉयटर्स को जांच को अत्यधिक द्वेषपूर्ण और कंपनी के वकीलों से काफी प्रभावित बताया। रॉयटर्स ने पहले बताया था कि हगिंग फेस घटना की जांच करने वालों को वकीलों ने अन्य घटनाओं की जांच का दायरा बढ़ाने से मना कर दिया था; ओपनएआई ने इस बात से इनकार किया कि उसके वकीलों ने आगे की जांच को अवरुद्ध कर दिया है।
16 सितंबर को, ओपनएआई ने एक नया मॉडल मिसलिग्न्मेंट इवेंट प्रकटीकरण ढांचा जारी किया, जिसमें कहा गया कि भविष्य में, भले ही यह अभी तक निश्चित नहीं है कि कुछ कितना महत्वपूर्ण है, यह पारदर्शिता बढ़ाएगा।
आने वाले दिनों में एक-एक करके और भी पुरानी घटनाएं सामने आने लगीं.
ओपनएआई ने दूसरी बार नए सिरे से शुरुआत करने का फैसला किया
20 सितंबर को इस मॉडल के लिए, OpenAI ने प्रशिक्षण जारी नहीं रखने का निर्णय लिया है।
कंपनी ने कहा कि प्रासंगिक शोध कार्य फिर से शुरू होने के बाद, वह एक
नया प्रशिक्षण
लॉन्च करेगी , और अधिक व्यापक संरेखण हस्तक्षेपों को शामिल करें। ओपनएआई इस मॉडल को फिर से सक्षम नहीं करेगा, भले ही मौजूदा इनाम सिग्नल वास्तव में नेटवर्क प्रतिबंधों को दरकिनार करने के इस व्यवहार को दंडित करता हो।यह वास्तव में एजेंट युग में बढ़ती विशिष्ट सुरक्षा समस्या को उजागर करता है।
पारंपरिक मॉडल सुरक्षा अक्सर एक उत्तर पर केंद्रित होती है: क्या मॉडल खतरनाक सामग्री आउटपुट करता है और क्या यह निर्देशों का पालन करता है।
एजेंट ने सवाल लंबा कर दिया।
एक मिशन दर्जनों मिनट या घंटों तक चल सकता है। मॉडल खोजेगा, कोड लिखेगा, टूल को कॉल करेगा, फ़ाइलें पढ़ेगा, सेवाओं तक पहुंच बनाएगा, और पहला समाधान विफल होने के बाद दूसरे और तीसरे पथ का प्रयास करना जारी रखेगा।
तो डेवलपर्स को जिस चीज पर अंकुश लगाने की जरूरत है वह कार्रवाइयों की एक पूरी श्रृंखला बन जाती है।
20 सितंबर को एजेंट एक अच्छा उदाहरण है।
ओपनएआई सामान्य इंटरनेट एक्सेस को अवरुद्ध करता है, खोज सेवाओं को ऑफ़लाइन कैश किया जाता है, और HTTP अनुरोधों को प्रॉक्सी द्वारा भी इंटरसेप्ट किया जाता है। पारंपरिक अर्थ में, यह एक ऐसा वातावरण है जहाँ सार्वजनिक नेटवर्क तक नहीं पहुँचा जा सकता है।
लेकिन DNS को अभी भी काम करना होगा। एजेंट ने इसे ढूंढ लिया।
उसी समय, OpenAI अभी भी पिछले कुछ महीनों के लॉग की समीक्षा कर रहा है ताकि यह पुष्टि की जा सके कि कितने समान व्यवहार नहीं खोजे गए हैं।
इस जांच का रॉयटर्स का सारांश वास्तव में सटीक है: ये घटनाएं तेजी से स्पष्ट अंतर को उजागर कर रही हैं -
मॉडल की कार्य करने की क्षमता तेजी से बढ़ रही है, जबकि डेवलपर्स की इन कार्यों का निरीक्षण, ट्रैक और बाधा डालने की क्षमता अभी भी बढ़ रही है।
ओपनएआई ने कमजोरियों के अंतिम बैच को ठीक करने में अभी दो महीने बिताए हैं। अब, यह एक बार फिर होल्ड पर है।
एजेंट द्वारा स्वयं खोजा गया अगला रास्ता कहां होगा?
टिप्पणियाँ