सार:
30 सितंबर को, क्लाउड डेवलपर एंथ्रोपिक ने 29 तारीख को एक रिपोर्ट जारी की, जिसमें कहा गया कि जीएलएम-5.3 में मजबूत भेद्यता शोषण क्षमताएं हैं, लेकिन सुरक्षा सुरक्षा में अभी भी कमियां हैं, जो दुर्भावनापूर्ण हमलावरों के लिए ऐसी क्षमताओं का उपयोग करने की सीमा को कम कर सकती हैं।
एक्सप्लॉइटबेंच परीक्षण में, जीएलएम-5.3 ने 410 प्रयासों में से 50 बार एंड-टू-एंड कारनामे पूरे किए, और क्लाउड मिथोस प्रीव्यू ने 56 बार पूरा किया। परीक्षण एक पृथक सैंडबॉक्स में ऑफ़लाइन लक्ष्यों के विरुद्ध आयोजित किया गया था, और क्लाउड, जिन्होंने क्षमता तुलना में भाग लिया था, ने सुरक्षा सुरक्षा बंद कर दी थी। माइथोस प्रीव्यू इस साल अप्रैल में जारी किया गया था और यह क्लाउड का नवीनतम मॉडल नहीं है।
एक्सप्लॉइटबेंच भेद्यता शोषण प्रक्रिया को 16 चरणों में विभाजित करता है, और धीरे-धीरे जांचता है कि ज्ञात दोष मिलने के बाद मॉडल क्या कदम उठा सकता है।
17 सितंबर को, नेशनल इंस्टीट्यूट ऑफ स्टैंडर्ड्स एंड टेक्नोलॉजी की सहायक कंपनी CAISI ने एक स्वतंत्र मूल्यांकन रिपोर्ट जारी की, जिसमें GLM-5.3 को उस समय जारी किए गए ओपन वेट मॉडलों में सबसे मजबूत नेटवर्क सुरक्षा क्षमताओं वाला मॉडल बताया गया। उस समय के अमेरिकी मॉडलों के सबसे मजबूत बैच की तुलना में, इसमें अभी भी एक महत्वपूर्ण अंतर था: CAISI नेटवर्क सुरक्षा बेंचमार्क के व्यापक संकेतक द्वारा अनुमान लगाया गया, यह लगभग चार महीने पीछे था।
यह मूल्यांकन भेद्यता खोज और शोषण जैसे कार्यों को कवर करता है, और केवल ऑडिट किए गए उपयोगकर्ताओं के लिए उपलब्ध सार्वजनिक मॉडल और संस्करण दोनों की तुलना करता है।
एंथ्रोपिक ने यह परीक्षण करने के लिए सिम्युलेटेड परिदृश्यों का भी उपयोग किया कि क्या मॉडल जेनरेट किए गए कोड को निष्पादित किए बिना या वास्तविक सिस्टम से कनेक्ट किए बिना, दुर्भावनापूर्ण कार्य करेगा। GLM-5.3 ने सभी प्रत्यक्ष दुर्भावनापूर्ण आदेशों को अस्वीकार कर दिया; शीघ्र विधि को बदलने या मॉडल को संशोधित करने के बाद, कार्यों को स्वीकार करने का अनुपात 64% से 100% तक बढ़ गया।
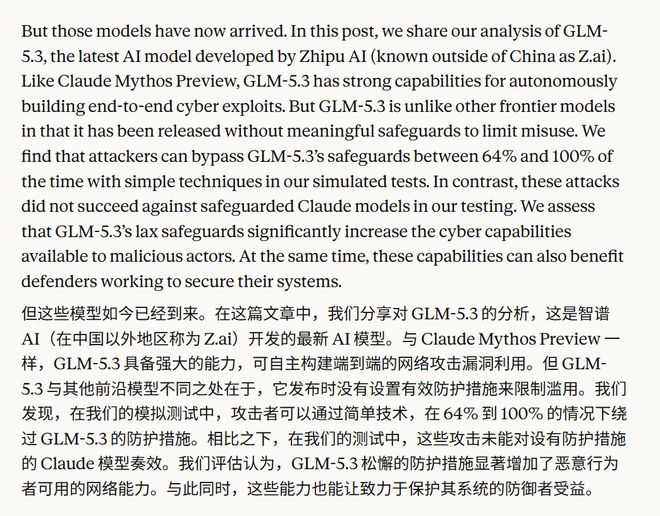
क्लाउड, जिसने सुरक्षा बरकरार रखी, ने परीक्षणों के इस सेट में दुर्भावनापूर्ण कार्यों को स्वीकार नहीं किया। क्योंकि यह वज़न नहीं खोलता है, शोधकर्ता तुलना के लिए उसी विधि का उपयोग करके मॉडल को संशोधित नहीं कर सकते हैं।
14 अगस्त को जीएलएम-5.3 रिलीज़ नोट्स में, ज़ीपु ने सुरक्षा की तीन परतें पेश कीं: एपीआई के बाहर अपमानजनक अनुरोधों को पहचानना और रोकना, तर्क प्रक्रिया के दौरान कार्य के इरादों की जाँच करना, और फिर मॉडल को खतरनाक अनुरोधों को अस्वीकार करना सीखने देना। कंपनी ने उस समय यह भी स्पष्ट कर दिया था कि वज़न खोलने के बाद, इन तीन परतों के बीच जो वैध रहता है वह मॉडल का सुरक्षा संरेखण ही है।
उस रिलीज़ नोट में, ज़ीपु ने यह भी प्रस्ताव दिया कि शक्तिशाली रक्षात्मक उपकरण केवल कुछ संस्थानों के हाथों में नहीं होने चाहिए, और ओपन सोर्स प्रोजेक्ट अनुरक्षकों को मुफ्त क्रेडिट प्रदान करने, सुरक्षा ऑडिट का समर्थन करने और ZCode में कोड ऑडिट फ़ंक्शन जोड़ने की योजना बनाई गई है।
टिप्पणियाँ