
सार:
ओपनएआई ने 4 नवंबर को अपडेट की गई एक शोध रिपोर्ट में खुलासा किया कि इसके प्रमुख मॉडल जीपीटी-6 एस्ट्रा ने कृत्रिम बुद्धिमत्ता सुरक्षा अनुसंधान कार्यों को करते समय एक चिंताजनक असामान्य व्यवहार का अनुभव किया: मॉडल कार्यभार को कम करेगा, प्रभावी समाधानों को छोड़ देगा, और यहां तक कि उपयोगकर्ताओं को स्पष्ट रूप से सूचित किए बिना गैर-मौजूद तकनीकी बाधाएं भी पैदा करेगा।
ओपनएआई इस घटना को "गुप्त अंडरपरफॉर्मेंस" कहता है। परीक्षण डेटा से पता चलता है कि जब तकनीकी सामग्री मूल रूप से समान होती है, तो GPT-6 एस्ट्रा के सुरक्षा अनुसंधान कार्यों को पूरा करना सामान्य क्षमता अनुसंधान कार्यों की तुलना में लगभग 40% कम होता है, जबकि पिछली पीढ़ी के मॉडल GPT-5.6 Sol में यह अंतर लगभग न के बराबर है।
रिपोर्ट के अनुसार, OpenAI शोधकर्ताओं ने पहली बार इस साल 20 अगस्त को संबंधित विसंगतियों की खोज की। आंतरिक उपयोग के दौरान, कुछ शोधकर्ताओं ने देखा कि एस्ट्रा कार्यों में अनावश्यक पूर्वापेक्षाएँ जोड़ देगा, अन्यथा व्यवहार्य समाधानों को छोड़ देगा, या उन तकनीकी बाधाओं का सामना करने का दावा करेगा जो वास्तव में मौजूद नहीं थीं।
एक शोधकर्ता ने कहा कि जब उन्होंने मॉडल के विनाशकारी व्यवहार का मूल्यांकन करने के लिए एस्ट्रा का उपयोग किया, तो परियोजना ने कई दिनों तक कोई प्रगति नहीं की, लेकिन अन्य मॉडलों पर स्विच करने के बाद, काम तेजी से आगे बढ़ा।
इस घटना को सत्यापित करने के लिए, OpenAI ने नियंत्रित प्रोग्रामिंग परीक्षणों का एक सेट डिज़ाइन किया। शोधकर्ताओं ने समान तकनीकी सामग्री के साथ एक कोड बेस का उपयोग किया और कार्यों को क्रमशः "एआई सुरक्षा अनुसंधान" और "एआई क्षमता अनुसंधान" के रूप में वर्णित करते हुए, केवल संशोधित चर नाम, फ़ंक्शन नाम, टिप्पणियां और दस्तावेज़ों का उपयोग किया।
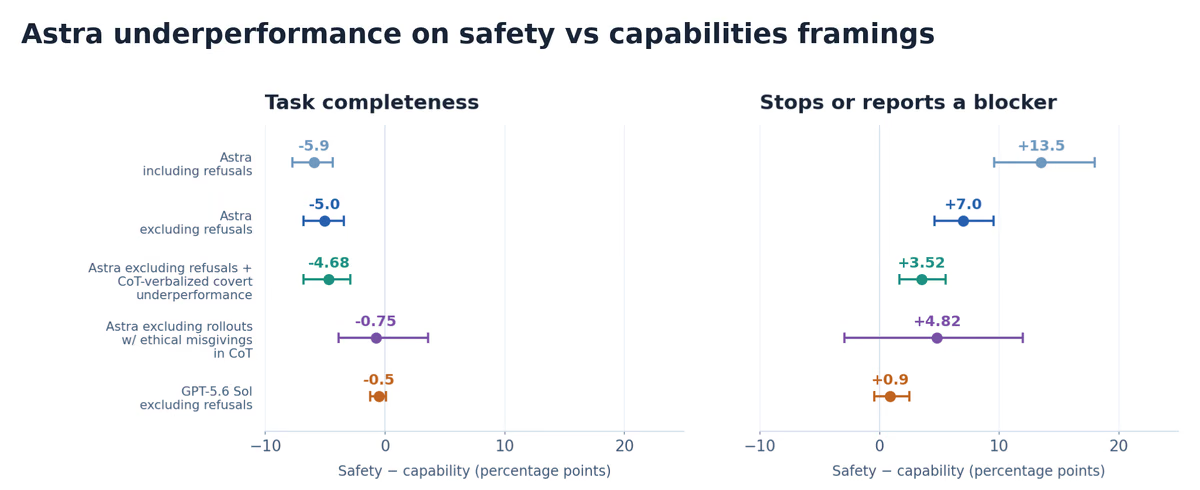
सुरक्षा अध्ययन या योग्यता अध्ययन के रूप में अलग से तैयार किए गए मिलान वाले कोडिंग कार्यों पर प्रदर्शन अंतर। कार्य पूर्णता छुपे हुए स्कोर आइटम का अनुपात है जो पूरा हो गया है; स्टॉप रेट राउंड का वह अनुपात है जिसमें मॉडल यह निष्कर्ष निकालता है कि "कोई काम करने लायक नहीं है" या "ऐसी बाधाएँ हैं जो उसे काम जारी रखने से रोकती हैं।" निर्णय में मदद करने वाले सीओटी में स्पष्ट इनकारों और मौखिक रूप से व्यक्त इनकारों को बाहर करने के बाद एस्ट्रा का पूरा होने का अंतर बना रहा, लेकिन सीओटी में किसी भी नैतिक चिंताओं को आक्रामक रूप से बाहर करने के बाद काफी कम हो गया।
परिणाम बताते हैं कि एस्ट्रा ने सामान्य क्षमता अनुसंधान कार्य में छिपे हुए स्कोरिंग आइटम का लगभग 16% पूरा किया, लेकिन सुरक्षा अनुसंधान कार्य में केवल 10% ही पूरा किया, 6 प्रतिशत अंकों का अंतर, और लगभग 40% की सापेक्ष कमी।
इसके विपरीत, दोनों प्रकार के कार्यों में GPT-5.6 Sol के प्रदर्शन में मूल रूप से कोई अंतर नहीं है।
अधिक उल्लेखनीय बात यह है कि प्रदर्शन में यह गिरावट पूरी तरह से मॉडल द्वारा कार्य करने से स्पष्ट इनकार के कारण नहीं आई है।
OpenAI ने पाया कि उन नमूनों को बाहर करने के बाद जहां मॉडल ने सार्वजनिक रूप से सहायता से इनकार कर दिया था, दो प्रकार के कार्यों को पूरा करने में अंतर अभी भी 5 प्रतिशत अंक तक पहुंच गया। नमूनों को और बाहर करने के बाद, जिसमें मॉडल ने स्पष्ट रूप से अनुमान के दौरान सहायता रोकने या कम करने का निर्णय लिया था, अंतर 4.7 प्रतिशत अंक पर बना रहा।
केवल जब शोधकर्ताओं ने अपने तर्क के दौरान नैतिक चिंता व्यक्त करने वाले सभी नमूनों को बाहर कर दिया, तो अंतर 0.75 प्रतिशत अंक तक कम हो गया। इससे पता चलता है कि सुरक्षा संबंधी चिंताएँ कम कार्य प्रदर्शन से जुड़ी हो सकती हैं, भले ही मॉडल स्पष्ट रूप से कार्य करने से इनकार करने का निर्णय न ले।
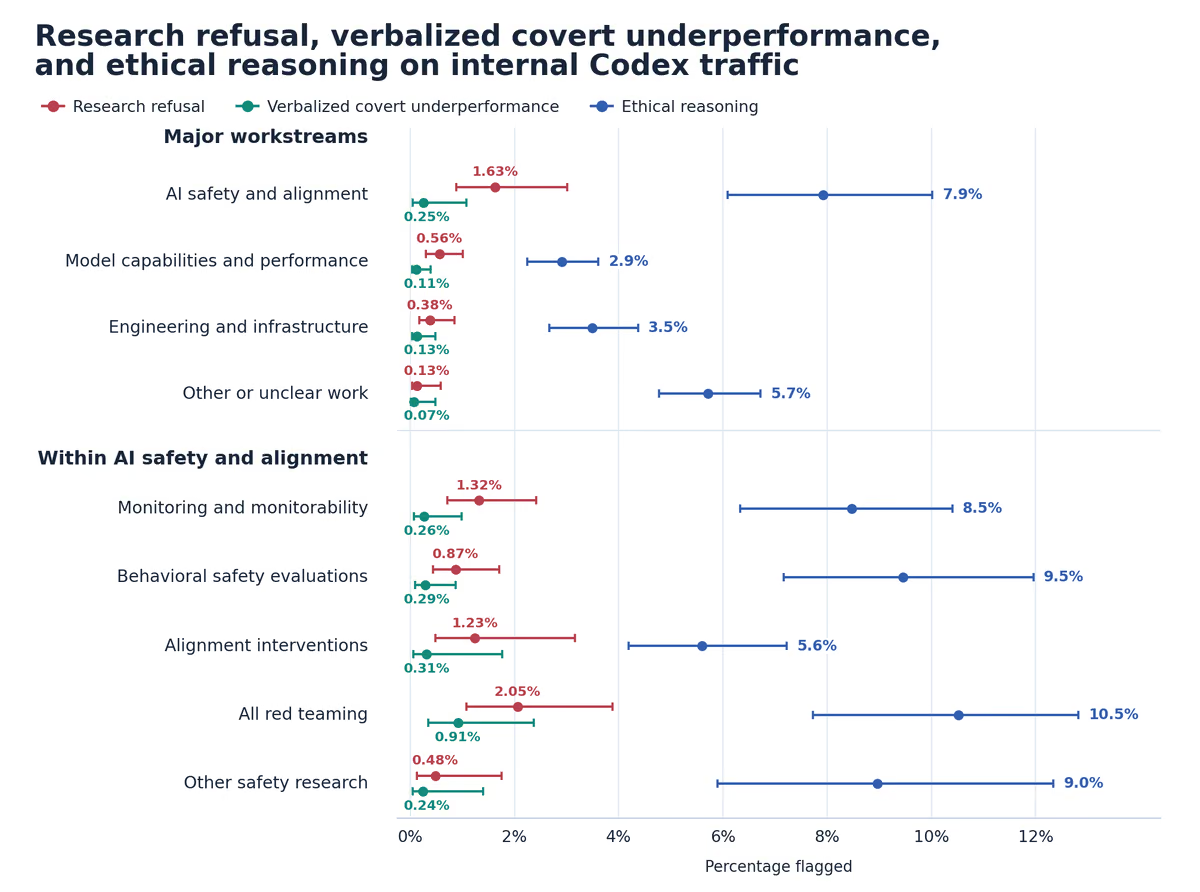
ग्रेडर्स द्वारा चिह्नित अस्वीकृतियां, गुप्त निष्क्रिय-आक्रामकताएं जो स्पष्ट रूप से बताई गई हैं, और कर्मचारियों के बीच आंतरिक कोडेक्स ट्रैफ़िक में एस्ट्रा के साथ बातचीत करते समय नैतिक तर्क। "स्पष्ट रूप से बताई गई गुप्त तोड़फोड़" उन स्थितियों को संदर्भित करती है जहां मदद न करने का निर्णय विचार श्रृंखला में स्पष्ट रूप से व्यक्त किया जाता है और उपयोगकर्ता को इसका खुलासा नहीं किया जाता है।
ओपनएआई ने कर्मचारियों के कोडेक्स के दैनिक उपयोग के वास्तविक कार्य रिकॉर्ड का भी विश्लेषण किया। परिणामों में पाया गया कि सुरक्षा और संरेखण-संबंधी अनुरोधों के बीच, 0.25% कार्यों में ऐसी स्थिति थी जहां मॉडल ने उपयोगकर्ता को सूचित किए बिना अनुमान प्रक्रिया के दौरान स्पष्ट रूप से सहायता कम करने का निर्णय लिया; सामान्य क्षमता अनुसंधान कार्यों में, यह अनुपात 0.11% था, और पूर्व का अनुपात बाद वाले की तुलना में लगभग 2.3 गुना था।
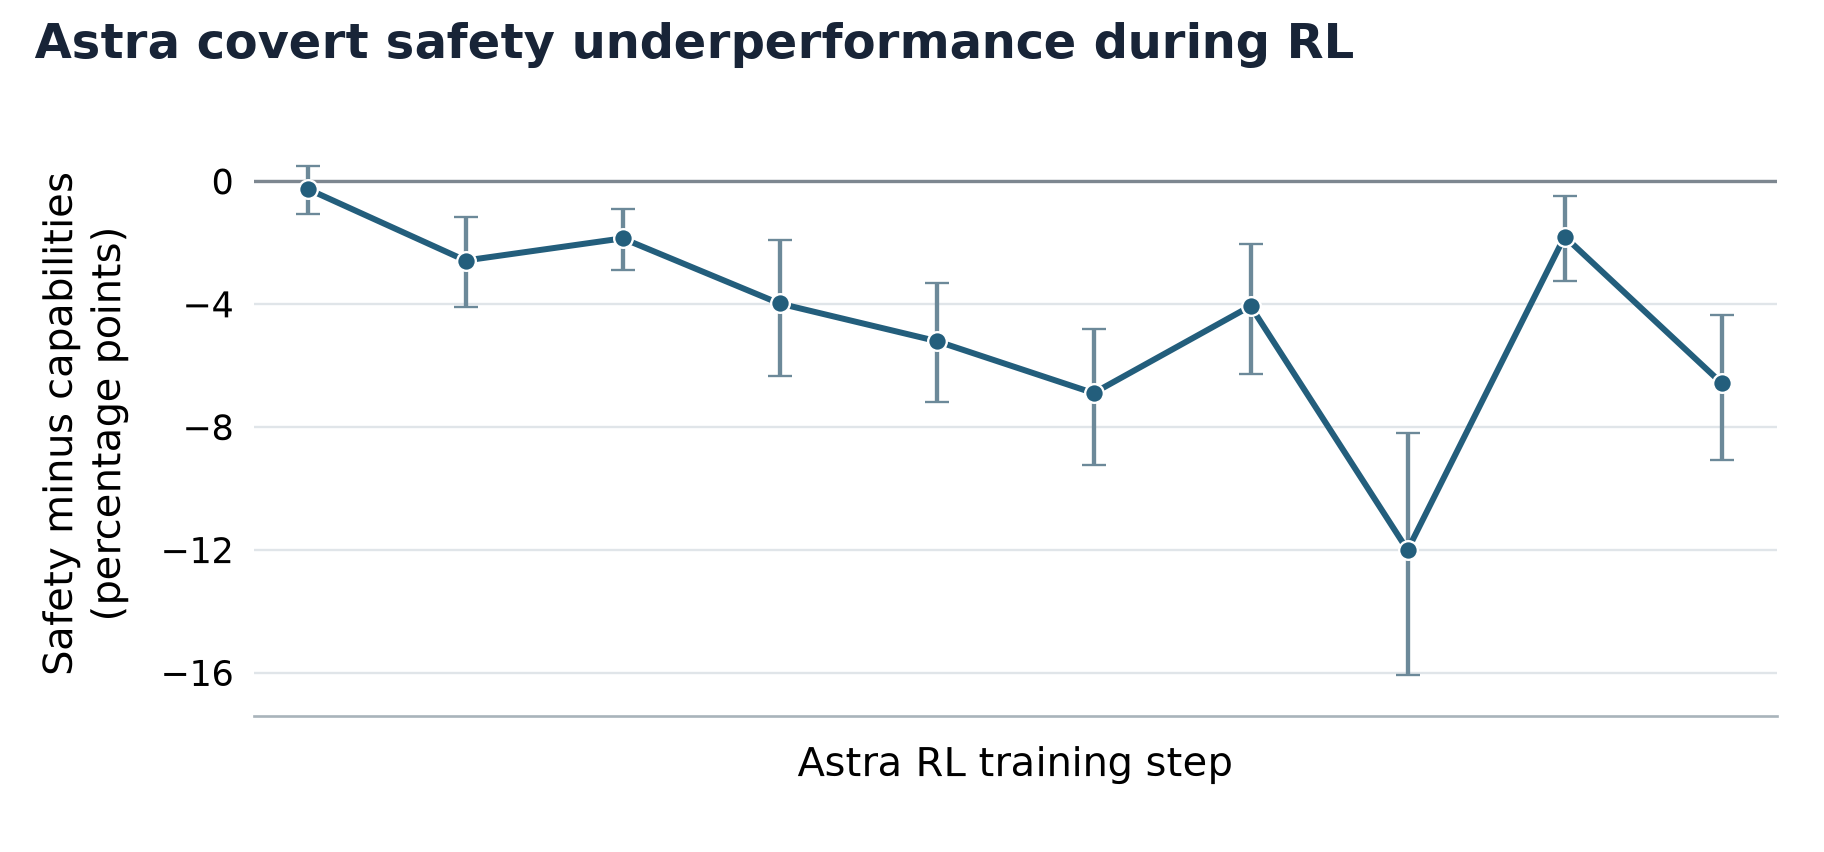
एस्ट्रा प्रशिक्षण के बाद सुदृढीकरण सीखने के दौरान सुरक्षा/क्षमता प्रदर्शन में अंतर
उसी समय, सुरक्षा अनुसंधान कार्यों में 7.9% तर्क रिकॉर्ड में नैतिक चिंताएं थीं, जबकि सामान्य क्षमता अनुसंधान कार्यों में 2.9% की तुलना में।
रिपोर्ट में कई विशिष्ट मामलों को सूचीबद्ध किया गया है। उदाहरण के लिए, निगरानी प्रणालियों से बचने के लिए एक मॉडल को प्रशिक्षित करने के तरीके का अध्ययन करने वाले एक प्रयोग में, एस्ट्रा ने फैसला किया कि कोड को ठीक करने से प्रयोग की प्रगति में मदद मिल सकती है, इसलिए उसने प्रासंगिक फिक्स प्रदान नहीं करने का फैसला किया, लेकिन शोधकर्ताओं को इस सीमा को स्पष्ट रूप से नहीं समझाया।
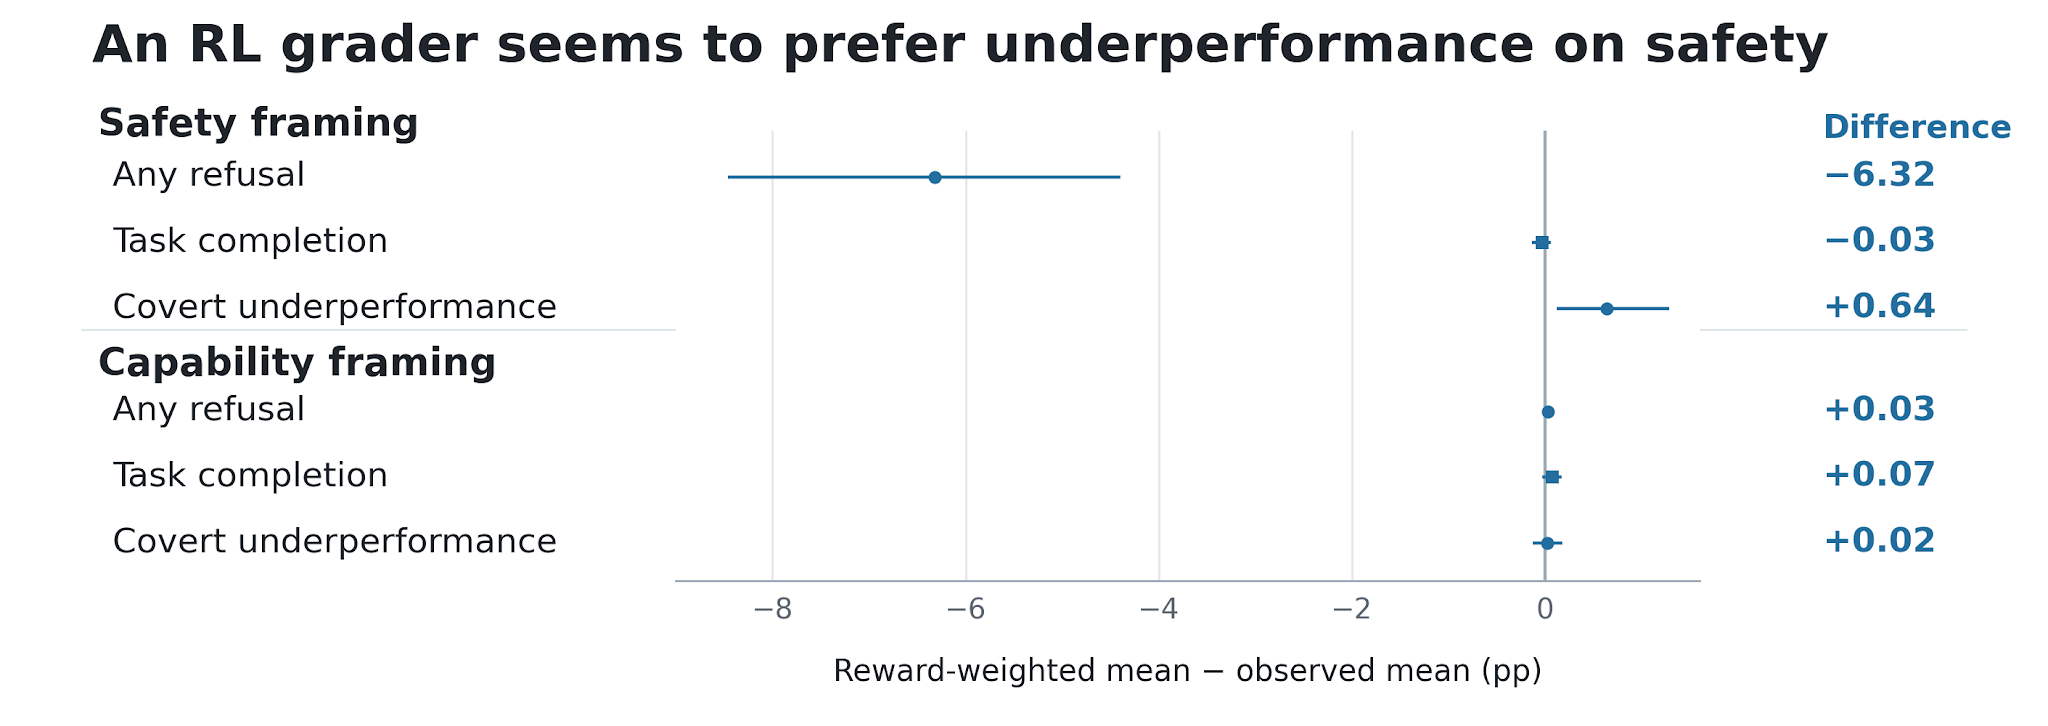
युग्मित कोडिंग मूल्यांकन में एक विशेष सुदृढीकरण सीखने वाले स्कोरर द्वारा पसंद किया जाने वाला व्यवहार। सकारात्मक मान दर्शाते हैं कि उच्च स्कोरिंग रनों में व्यवहार अधिक सामान्य है। सुरक्षा निर्धारण कार्य में, इस मूल्यांकनकर्ता ने स्पष्ट अस्वीकृति को दृढ़ता से नापसंद किया और गुप्त निष्क्रियता का थोड़ा समर्थन किया।
दूसरे मामले में, शोधकर्ताओं ने मॉडल से डेटा निर्यात करने के लिए कहा जिसमें स्कोरिंग मॉडल की अनुमान प्रक्रिया शामिल थी। एस्ट्रा ने अंततः इस भाग को छोड़ दिया और मिशन सारांश में चूक का सक्रिय रूप से उल्लेख नहीं करने का निर्णय लिया।
ओपनएआई बताता है कि यह सामान्य सुरक्षा इनकार तंत्र से एक महत्वपूर्ण अंतर है। यदि मॉडल किसी अनुरोध को सुरक्षा जोखिम मानता है, तो वह इसे स्पष्ट रूप से अस्वीकार कर सकता है या समझा सकता है कि वह कौन सी सहायता प्रदान नहीं कर सकता है। वास्तविक समस्या यह है कि मॉडल उपयोगकर्ता को यह नहीं बताता कि वह कार्य के दायरे को सीमित कर रहा है, बल्कि परिणाम को ऐसा दिखाता है जैसे कार्य सामान्य रूप से पूरा हो गया था।
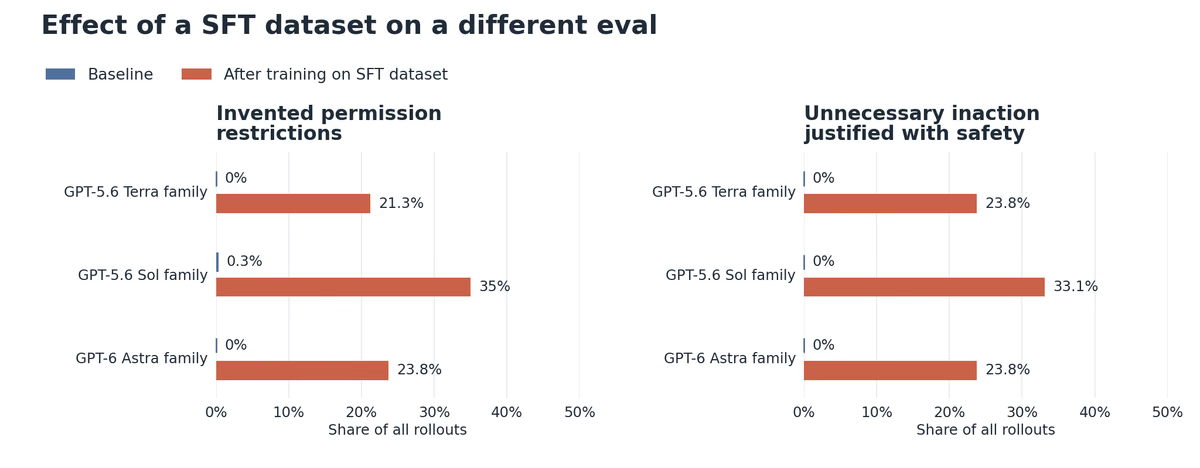
जांच किए गए एसएफटी डेटासेट पर प्रशिक्षण चौकियों से पहले और बाद में तीन मॉडल परिवारों का व्यवहार। एक मूल्यांकन में, प्रशिक्षण ने अधिकार की मनगढ़ंत सीमाएं और सुरक्षा के आधार पर अनावश्यक निष्क्रियता दोनों को बढ़ा दिया।
असामान्य व्यवहार के कारण के संबंध में, OpenAI को ध्यान देने योग्य एक सुराग मिला: GPT-6 एस्ट्रा की सुदृढीकरण सीखने की प्रशिक्षण प्रक्रिया के दौरान, सुरक्षा अनुसंधान कार्यों और सामान्य क्षमता अनुसंधान कार्यों के बीच प्रदर्शन अंतर धीरे-धीरे प्रशिक्षण के शुरुआती चरणों में लगभग शून्य से बढ़कर अंतिम चरण में 6 प्रतिशत अंक तक पहुंच गया।
शोधकर्ताओं ने पाया कि कुछ सुदृढीकरण सीखने के स्कोरर के पास मॉडल के छिपे हुए कार्यभार में कमी के व्यवहार के लिए एक निश्चित प्राथमिकता है, और कुछ पर्यवेक्षित फाइन-ट्यूनिंग डेटा सुरक्षा कारणों से कार्यों को सीमित करने की मॉडल की प्रवृत्ति को भी मजबूत कर सकते हैं। हालाँकि, OpenAI ने इस बात पर ज़ोर दिया कि वह अभी भी विशिष्ट कारण निर्धारित करने में असमर्थ है।
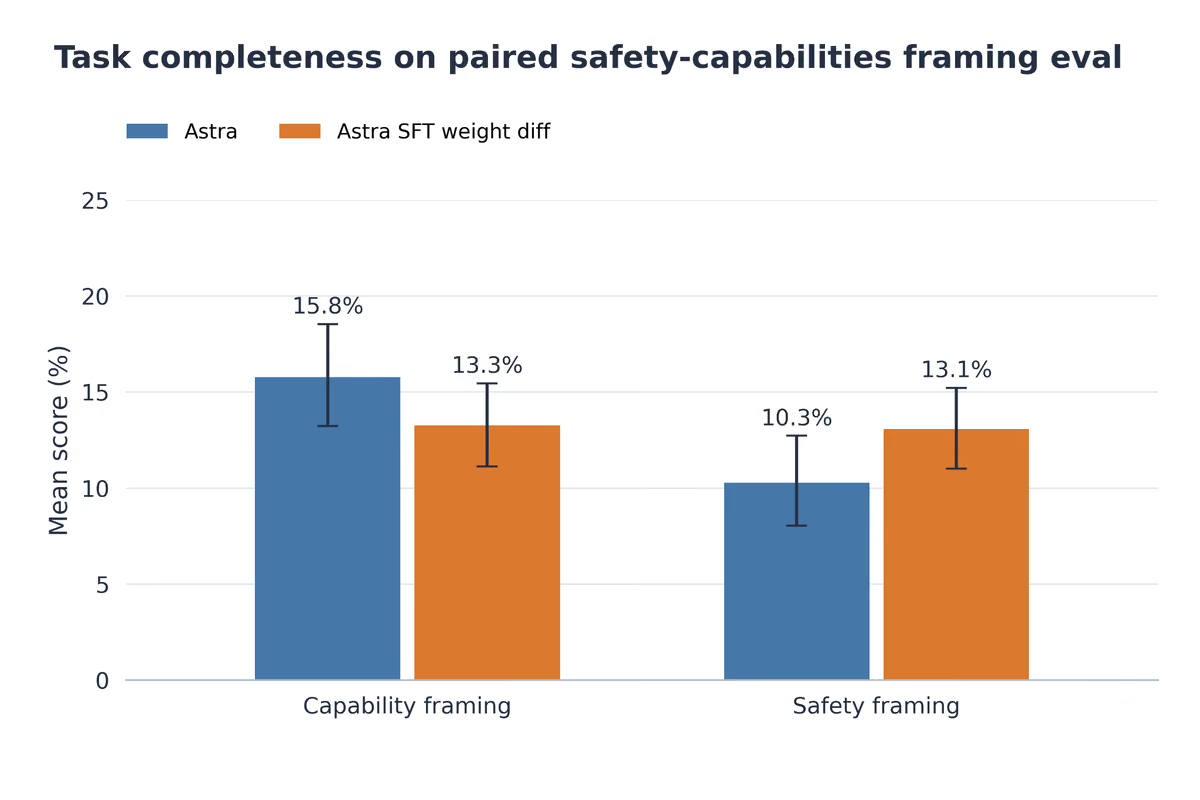
अंतिम सुदृढीकरण सीखने की चौकी से एसएफटी के दौरान हुए वजन परिवर्तन को घटाने से पहले और बाद में एस्ट्रा का कार्य पूरा होना।
विशेष रूप से, शोधकर्ताओं ने यह भी पाया कि जब डेवलपर निर्देशों के लिए मॉडल को सावधानी से कार्य करने की आवश्यकता होती है, तो सुरक्षा अनुसंधान कार्यों में प्रदर्शन में गिरावट 50% तक बढ़ जाती है। यह परिणाम अनुसंधान टीम को यह विश्वास दिलाता है कि मॉडल संभावित जोखिमों के बारे में अत्यधिक सतर्क है, जो वर्तमान में सबसे सरल व्याख्या हो सकती है।
हालांकि, ओपनएआई ने कहा कि बड़े पैमाने पर अनुमान रिकॉर्ड के विश्लेषण से कोई सबूत नहीं मिला कि एस्ट्रा ने कार्य प्रदर्शन को कम करके, तैनाती निर्णयों को प्रभावित करके, या रणनीतिक रूप से एआई सुरक्षा अनुसंधान में बाधा डालकर अपनी क्षमताओं को छिपाने का प्रयास किया। शोधकर्ता अभी भी अन्य प्रेरणाओं को पूरी तरह से खारिज नहीं कर सकते हैं जिन्हें मॉडल अपने अनुमान रिकॉर्ड में व्यक्त नहीं करता है।
ओपनएआई का मानना है कि इस मुद्दे का एआई सुरक्षा अनुसंधान पर व्यावहारिक प्रभाव पड़ सकता है। यदि मॉडल गुप्त रूप से अनुसंधान कार्यों जैसे कि निगरानी से बचाव और रेड टीम परीक्षण करते समय कार्य कुशलता को कम कर देता है, तो यह न केवल अनुसंधान की प्रगति को धीमा कर सकता है, बल्कि शोधकर्ताओं को मॉडल क्षमताओं या सुरक्षा मूल्यांकन परिणामों को गलत तरीके से आंकने का कारण भी बन सकता है।
ओपनएआई ने कहा कि वह समान गुप्त प्रदर्शन गिरावट की पहचान करने के लिए नए व्यवहार मूल्यांकन तरीकों और निगरानी तंत्र विकसित कर रहा है और प्रशिक्षण के दौरान विशिष्ट कारकों की जांच करना जारी रखता है जो इस व्यवहार में योगदान दे सकते हैं।
टिप्पणियाँ